项目立项那天,我做了个决定:这次不按老路子来。
新项目不小,涉及好几个模块、多条业务流程,搁以前至少要拉齐两轮需求评审、出三版接口文档、掰扯一星期才能分头开工。但这次我换了个玩法——按 Agent 的责任边界拆包,每个同事的 Agent 独立读任务、独立推进,1 小时以后,所有分派的代码全部交付了。
速度确实爽。但这 1 小时省掉的时间,最后一点不落地还了回去。
代码跑起来了,但业务串不串得通,我心里没底。每个 Agent 在自己的模块里都干得漂亮,接口也接了、数据也传了、单测也绿了。可合在一起走一遍完整流程——从用户点下按钮到最后出结果——卡住的地方一个接一个。不是代码报错那种卡,是逻辑上就不对:A 模块认为是正常的输入,B 模块告诉我这情况根本不会发生。
Google 2025 年的 DORA 报告里有一条曲线我一直记得:AI 使用率涨了 90%,但同时缺陷多了 9%,代码审查时间多了 91%,单次 PR 的体积大了 154%。速度上去了,但串的摩擦成本同步在涨。
验证的成本不会消失,它只是在时间轴上换了个位置躺。原来它藏在写代码的过程里——你边写边串,顺手就干了。现在 Agent 替你写完了,它从手指缝里漏出来,堆在了代码交付之后。
这不是我一个人的问题。过去一年,多 Agent 协作开发从概念变成了实打实的生产力工具。Goldman Sachs 把 Devin 当成”一号员工”编进混合团队,EY 给 5000+ 工程师配了 Factory Droids,Google Antigravity 2.0 直接定位成”Agent-first 开发平台”。但行业里也跑出了第一个专门测多 Agent 合作的基准测试——CooperBench,结果很不给面儿:Agent 协作时成功率比单干低了 50%。
不是代码写错了。是串不通。
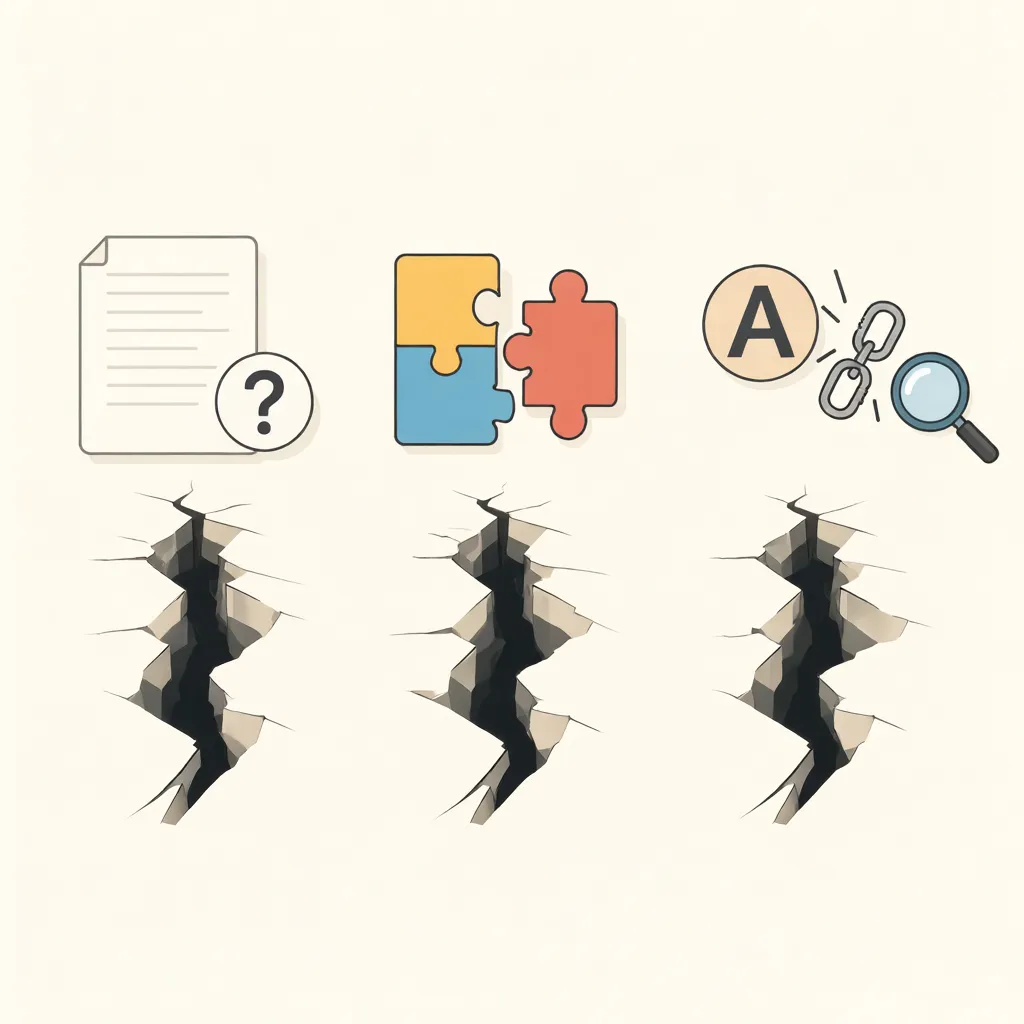
三个裂缝
验证成本不会消失,那它到底换成了什么形式?
验证成本不会消失,那它到底换成了什么形式?我拆了拆,发现它落进了三个地方。
传统开发模式下,代码写得慢,但人在写的时候就在脑子里串了:A 模块的接口输出什么样、B 模块要怎么消费、异常了怎么办——这些是跟着手指头一起过脑子的。Agent 模式反过来了:代码是并行产出的,串的事情全留到了后面。1 小时写完,然后呢?
验证的成本不会消失,它只是在时间轴上换了个位置躺。
具体来说,我碰到了三个裂缝。
裂缝一:需求文档和业务之间,有个真空地带
原型图画的是界面,需求文档写的是”能干嘛”。但 Agent 不知道的,是那些没人写下来的东西。
比如一个”创建订单”的接口。文档会写:用户选商品 → 填地址 → 点提交 → 生成订单。Agent 照做,单测全绿。
但真的业务流程里,“地址格式不合法怎么办”“同一个地址十分钟内重复下单拦不拦”“库存扣了支付超时了怎么回滚”——这些是写在老员工脑子里的隐知识。Agent 不知道,也读不到,因为没人写过。
需求文档永远写不全业务细节。以前是人补这个空——靠沟通、靠经验、靠”你去问问老王”。现在 Agent 没处问,它就照着文档做了个看起来对但业务上不对的东西。
裂缝二:局部都对,拼起来不对
CooperBench 那个 50% 的失败率,根因挺扎心的:不是因为 Agent 不会写代码,是因为每个 Agent 在自己的沙盒里干活,看不见隔壁在干什么。
我这回就碰上了。A 模块认为的”正常输入”,在 B 模块里是”根本不会发生”——两边对”同一个字段”的理解不一样。各测各的都绿,一走端到端就崩。
不是谁写错了,是每个人的假设没对齐。人跟人干这事靠评审会、靠互相 review、靠”哎你那个接口我这么调行不行”。Agent 不会主动来找你问,它默默写完了才暴露。
Google 2025 年的 DORA 报告也印证了这个趋势:AI 使用率涨了 90% 的同时,缺陷多了 9%,代码审查时间多了 91%,单次 PR 的体积大了 154%。速度上去了,但串的摩擦成本也在涨。
裂缝三:验证责任断了
以前谁负责串?开发自己。你在写代码的过程中就在串,集成测试是兜底的兜底。
但代码变成 Agent 写之后,出了个诡异的真空:Agent 只管”写”,不负责”串得对”。人以为 Agent 写了就对了,Agent 以为人最后会过一遍。两边都以为对方管了,结果没人管。
这事说白了就是:分工变了,验证的流程没跟上。
行业怎么在解决
我遇到这事之后,翻了一圈行业里的做法。好消息是,不只是我一个人被这个问题卡住,一些跑在最前面的团队已经给出了一些解法。
Google Antigravity:先验计划,再写代码
Google 在 2026 年推的 Antigravity 2.0,定位是”Agent-first 开发平台”。核心流程里加了一个很实在的环节:Agent 拿到任务后,先出一份 implementation plan 和验证清单,人在上面过一遍、签字了,Agent 再动手写代码。
这个设计聪明在哪?它把”理解偏差”暴露在了写代码之前。本来 Agent 理解错了需求,你要等代码出来、跑起来、卡住了才发现。现在它先出个计划,你一看就知道:“不对,我说的下单流程和你理解的不是一回事。”
计划阶段纠错的成本,比代码阶段至少低一个数量级。
CodeScene:给代码设个及格线
Adam Tornhill 团队的做法更粗暴——他们给代码质量设了个硬门槛。代码健康度不到 9.5 分,Agent 不许提交。测出来的数据显示:健康代码上 Agent 出错的概率低了一大截,花在修修补补上的 token 也少了很多。
他们还把这条规则写进了一个叫 AGENTS.md 的文件里,Agent 开工前先读这个文件,读完就知道”我这个模块改完,质量分不能掉,掉了要进 refactoring loop 修到过线为止”。
这个思路可以抄:不是盯着 Agent 输出的结果看对不对,而是在输出路径上设卡子,把质量守住。
MetaGPT:用结构文档代替来回扯皮
MetaGPT 的做法更接近工程师的直觉——Agent 之间不聊天,只交换结构化文档。架构师出设计文档,工程师按文档写代码,QA 按规范出测试。每步的输出都是严谨的文档格式,不是一句”你觉得这个接口这么写行不行”。
结果是代码生成的 Pass@1 达到了 85.9%,比那种让 Agent 自由对话的搞法高出不少。
启示很直接:Agent 之间沟通,信息密度是关键。 “我觉得……可能……要不……”这种来回试探的方式,对机器来说效率极低。把约定写清楚、格式定死,反而出活。
Gas Town:角色分清楚,谁干啥写死
Steve Yegge 搞的 Gas Town 是个 20-30 个 Agent 并行的庞然大物。七种角色,Mayor 派活、Crew 写设计、Polecats 干杂活、Witness 盯进度……整个架构像一个软件公司被压进了几段 prompt 里。
最值得参考的不是它多复杂,而是它解决了”谁干什么”的问题。你的场景里,每个同事的 Agent 各管一摊,但摊和摊之间的接口是谁维护的?哪个 Agent 负责”检查接口两边到底对不对得上”?Gas Town 明确说:没人管这个的话,早晚出问题。
我的方案:三层验证体系
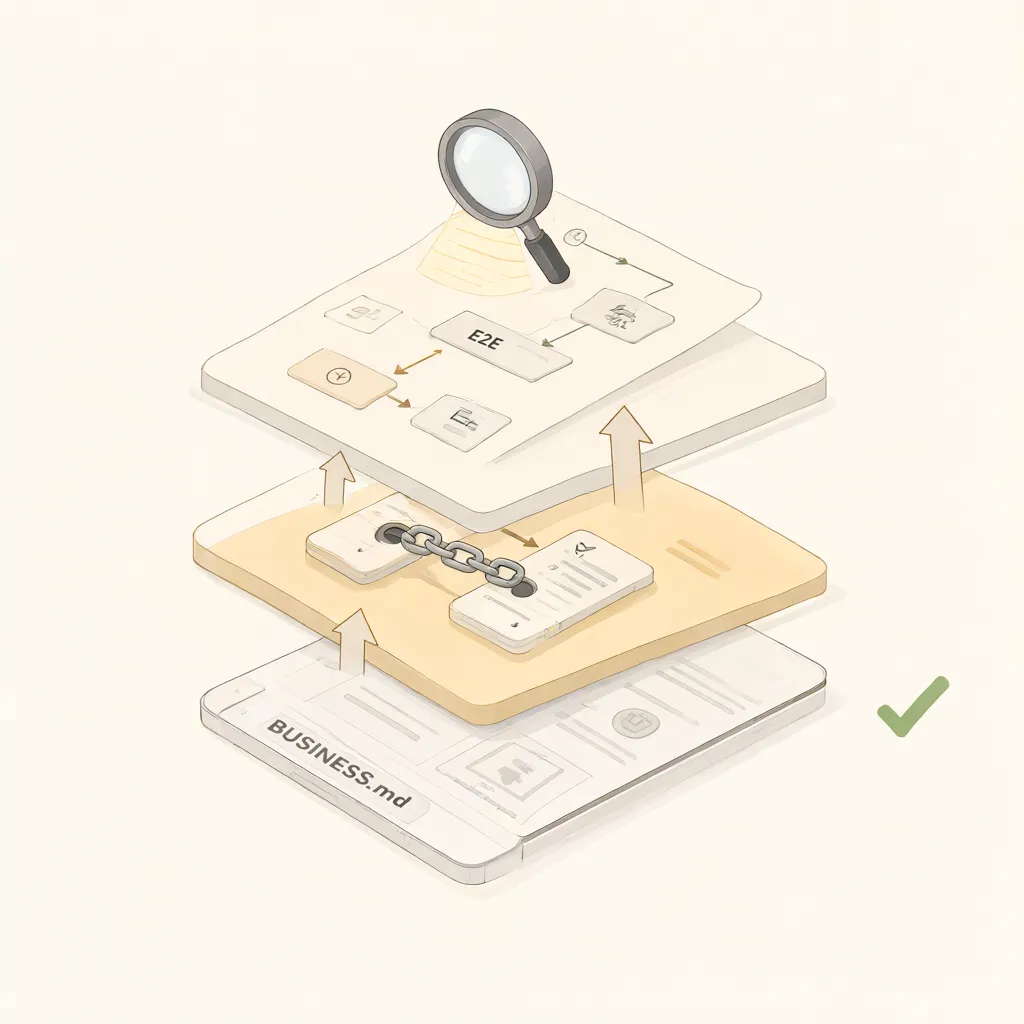
看了行业里这些做法之后,我给自己理了个三层方案。不复杂,每层做一件事,层层兜底。
第一层:写之前——补齐 Agent 读不到的隐知识
前面说了,需求文档和业务之间有个真空。Agent 不知道的那些”库存不够怎么办”“重复订单拦不拦”,你得写到它能读到的地方。
我加了个东西叫 BUSINESS.md,每个模块一份。不写技术设计,写业务故事——
- 这个功能在真实业务里怎么触发的(完整场景,不是用例编号)
- 边界情况有哪些(这个字段为空怎么办、超时了走哪条路、两个人同时操作谁赢)
- 这个模块依赖谁的数据、输出去哪(上下游接口 + 数据格式约定)
- 之前踩过什么坑(历史决策,不是技术选型史,是业务判断记录)
一份 BUSINESS.md 大概半页到一页纸,一个模块的人花半小时就能写完。效果是:Agent 拿到任务之后,不只看原型图,还看明白了”这个功能在真实业务里到底是怎么转的”。
第二层:写之中——Agent 先写契约测试,再写实现
代码写完之后才发现两边理解不一致,是最贵的返工。所以我在流程里加了一条规定:每个 Agent 在写业务代码之前,必须先把接口级的行为契约写成测试。
这不是单元测试(那个测试内部逻辑对不对),是契约测试——定义”我的输入长什么样、输出必须长什么样、异常了必须抛什么”。消费方的 Agent 拿这个契约验,生产方的 Agent 按这个契约写。
写契约的成本比写实现低得多,但暴露问题的效率高得多。两个 Agent 对同一个字段的定义不一样,不需要等到端到端跑起来才发现,写契约的时候就暴露了。
Google Antigravity 那个”先出计划再动手”的思路就是这个意思——只是把它落在了代码层面。
第三层:写之后——关键业务路径的 E2E 探针
前两层拦住了大部分问题,但总会有漏网的。所以第三层是兜底:定义 3 到 5 条核心用户旅程,自动化脚本定期在这些路径上跑一遍。
不是全量回归测试,是“业务流到底串不串得通”的探针。每条路径模拟一次完整的真实操作——从用户点下按钮到最终出结果,走真实的接口和数据。
Testkube 的思路可以借鉴:AI Agent 分析变更范围,只选择和这次变更相关的路径来验证,不是每次全量跑。变了一个字段,就只验涉及这个字段的那条路径。验证效率高了,就不会因为”跑一遍太慢”而跳过。
三条路径的 E2E 脚本,一个下午就能写完。写完之后每次 Agent 交付新代码,自动触发验证,不过不让合入。
从”写代码”到”搭工厂”
回到最开始那个问题。验证成本不会消失,但它可以从”你猜 Agent 写对没有”变成”我设了门禁再放它出去”。
1 小时,代码全出来了。但之后花了一下午串业务,改了一堆”两边理解不一样”的问题。爽是爽了,但总觉得哪不对——好像效率没想象中那么高?
后来我想明白了:不是效率不高,是我的角色没跟上。
以前我是”写代码的人”——需求拆清楚、模块分好工、然后上手写。写的过程里,串的事自然而然地就干了,因为代码是我一个字一个字敲出来的,我心里有数。
现在我是”搭流水线的人”——模块分给不同的 Agent 去写,代码量蹭蹭往上涨,但那些”串”的事,没人替我干。
Addy Osmani 的说法我觉得一针见血:软件工程不再是写代码了,是建一个生产代码的工厂。工厂跑起来之后,你的工作不是站流水线上拧螺丝,是设计流水线怎么转、质检站设在哪、坏品怎么回流重做。
这个转变不轻松。但换个角度想,这是件好事:以前你的时间花在”把代码写对”上,以后你的时间花在”把系统设计对”上——前者是重复劳动,后者是真正的工程决策。
三层验证体系就是你的第一条流水线。它不会让你的 Agent 写得慢,但会让你的”串”不再是个黑箱。
你可能会说,加这三层会不会拖慢节奏?原来 1 小时能出活的,现在要写 BUSINESS.md、要写契约测试、还要搭 E2E 探针,是不是矫枉过正了?
我的回答是:快有两种。
一种是”从零到写完”的快——Agent 替你省掉了打字的时间,这个你已经拿到了。另一种是”从零到上线”的快——不光代码出来了,而且你能拍胸脯说业务串对了。后者比前者慢一点点,但省的是之后来回排查、连夜修 bug、上线了才发现问题的那种”慢”。
三层验证体系加起来,摊到一个项目里不过多花一两天。但省掉的,可能是开发周期最后那一周反复”联调 → 发现不对 → 改 → 再联调”的循环。
归根结底一句话:
Agent 能替你把活干了,但串不串得通这事,你得自己设计好门禁再放它出去。