如果你也有一台 DGX Spark,或者正在琢磨要不要入手一台来跑本地大模型,那你大概率会遇到同一个问题:模型装进去了,速度却提不上来。
最近我一直在折腾 DGX Spark 上跑 Qwen3.8-27B。
最开始部署起来的时候,模型倒是能正常回答问题,但速度总觉得差点意思。
我自己折腾下来,开着 MTP 的时候大概是 24 tok/s。
对于日常聊天,这个速度不是完全不能接受。但如果把它放到智能体场景里,情况就不一样了。Agent 要不断思考、调用工具、接收结果,再继续生成。每一步都要等,整个流程下来就会感觉有点拖沓。
然后我就开始琢磨:DGX Spark 这台机器,真的只能跑到这个速度吗?
后来翻了一些国外开发者的测试,又换了不同的推理引擎和解码方式,发现同一台机器、同一个模型,跑出来的结果差距还挺大。
有些配置能把速度提高不少,但也有一些看着很漂亮的参数,真正部署起来却不太稳定。
这篇就聊聊我这段时间折腾 Qwen3.8-27B 的过程。
先说一个容易忽略的问题:模型装得下,不代表跑得快
DGX Spark 使用的是 NVIDIA GB10 Grace Blackwell Superchip,配备 128GB 统一内存,官方标称内存带宽为 273GB/s。
它最大的特点,是 CPU 和 GPU 共享一块统一内存。
这对本地运行大模型很有帮助。以前想在桌面设备上运行比较大的模型,显存经常是第一道坎。现在有了 128GB 统一内存,模型能装进去的范围大了不少。
但模型能装进去,只是解决了能不能运行的问题,并没有解决每秒能生成多少 Token。
Qwen3.8-27B 大约有 270 亿参数。模型每生成一个 Token,都需要进行大量计算,同时还要不断从内存中读取模型参数。
可以把它想成一个资料室。资料室足够大,说明所有资料都能放进去;但每次取资料的速度,决定了整个流程快不快。
这就是内存带宽为什么重要。
有一组公开测试使用 BF16 格式的 Qwen3.8-27B 模型,检查点文件约 55.6GB。用 DGX Spark 的 273GB/s 标称带宽粗略计算:
273 ÷ 55.6 ≈ 4.9
当然,这只是一个粗略估算。实际速度还会受到缓存、计算内核、运行时和模型精度等因素影响,不能直接把这个除法当成性能上限。
所以,想把 DGX Spark 的速度跑上去,不能只盯着硬件参数,还得看模型格式和推理框架怎么配合。
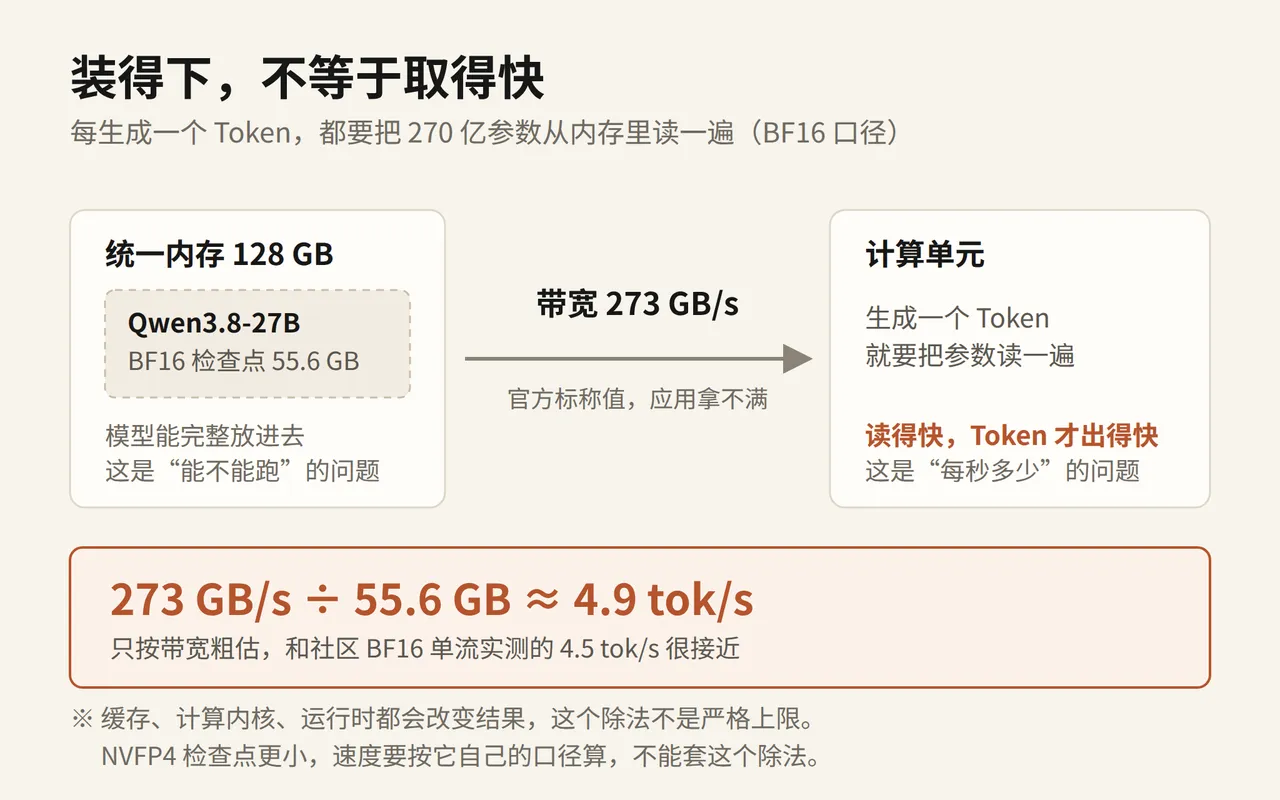
内存装得下,不等于取得快:273 GB/s ÷ 55.6 GB ≈ 4.9 tok/s 只是 BF16 口径的粗估
第一种办法:先用模型自带的 MTP
我最先关注的是 MTP。
普通解码的过程比较直接:模型每次生成一个 Token,再根据这个 Token 继续生成下一个。
MTP(Multi-Token Prediction)可以理解成让模型提前猜后面几个 Token,再交给主模型检查。猜对的部分可以直接留下,不需要每个 Token 都完整走一遍生成流程。
Qwen3.8-27B 本身就带有多 Token 预测头,不需要额外加载一套小模型来做草稿。
这也是我认为它适合先尝试的原因:改动相对少,可以先建立一套性能基线。
国外开发者 Nishaanth Reddy 做过一组测试,使用 50 道 HumanEval+ 编码题,每道题采样一次,并发为 1,开启 thinking,输出上限为 16384 Token。
测试结果如下:
| 推理引擎 | 普通解码 | 开启 MTP |
|---|---|---|
| SGLang | 12.65 tok/s | 24.20 tok/s |
| vLLM | 10.95 tok/s | 20.89 tok/s |
| llama.cpp | 10.80 tok/s | 22.20 tok/s |
这里的推理引擎你可以理解成"跑模型的驱动程序"——SGLang、vLLM、llama.cpp 是目前主流的三个选择,底层逻辑不同,但对使用者来说差别是你装哪个、启动命令怎么配。
从这组结果看,SGLang 开启 MTP 后,从 12.65 提升到了 24.20 tok/s。
生成同样长度的内容,等待时间明显缩短了。
不过要注意:这组测试比较的是完整部署方案。不同推理引擎使用的模型转换和量化实现并不完全相同,不能把所有差异都归功于 MTP。
如果你刚开始部署 Qwen3.8-27B,我建议先把普通解码和 MTP 两组结果跑出来,作为后续优化的参照。
第二种办法:再加一个专门的草稿模型 DSpark
MTP 是模型自己预测后续 Token。
DSpark 则是另一种思路:额外加载一个专门训练的小型草稿模型,先由它猜测后面的内容,再让真正的 27B 模型进行验证。
这种方式叫投机解码。
打个比方,普通解码是每写一个字都要请主编审核一次;投机解码则是先让助手写一段草稿,主编一次检查其中能通过的部分。
理论上,草稿模型越快、预测越准,整体提速空间就越大。
同一组公开编码测试中,DSpark 的结果是(下面这些速度只算开始出字之后的生成阶段,按输出 token 加权,不含首字等待和排队):
| 推理引擎 | DSpark 加权净解码速度 |
|---|---|
| SGLang | 27.96 tok/s |
| vLLM | 25.58 tok/s |
| llama.cpp | 19.70 tok/s |
这里有个挺有意思的现象:SGLang 和 vLLM 都有提升,但 llama.cpp 的结果反而低于它自己的 MTP 测试。
所以,不能看到某种投机解码方案有效,就认为换到所有引擎上都会更快。
而且 DSpark 还有一个现实问题:它需要单独加载草稿模型。
目标模型、草稿模型、对话缓存和运行时都要占用内存。DGX Spark 虽然有 128GB 统一内存,但也不是可以无限制地往里塞东西。
我自己部署时就遇到过一次内存压力导致的硬重启。这件事让我意识到,不能只看启动成功后的速度,还得看高负载下的内存余量和故障恢复。
如果要长期运行智能体服务,稳定性比一次跑出来的最高速度重要得多。
第三种办法:DFlash2,长文本生成还有更大的提速空间
接下来是 DFlash2。
它同样属于投机解码,但和 DSpark 的工作方式不完全一样。
DSpark 是让草稿模型逐步猜测后面的内容,DFlash2 则采用块扩散草稿器,一次提出一整块候选内容,再交给目标模型验证。
在前面那组公开的长编码测试里,SGLang + DFlash2 的加权净解码速度达到了 36.59 tok/s。
和开启 MTP 的 24.20 tok/s 相比,大约是它的 1.5 倍。
对比一下:
| 方案 | 速度 | vs 普通解码 |
|---|---|---|
| SGLang 普通解码 | 12.65 tok/s | — |
| SGLang + MTP | 24.20 tok/s | 1.91× |
| SGLang + DSpark | 27.96 tok/s | 2.21× |
| SGLang + DFlash2 | 36.59 tok/s | 2.89× |
换算成实际等待时间,生成 1000 Token:
- 普通解码约需要 79 秒。
- DFlash2 约需要 27 秒。
这个差距已经比较明显了。
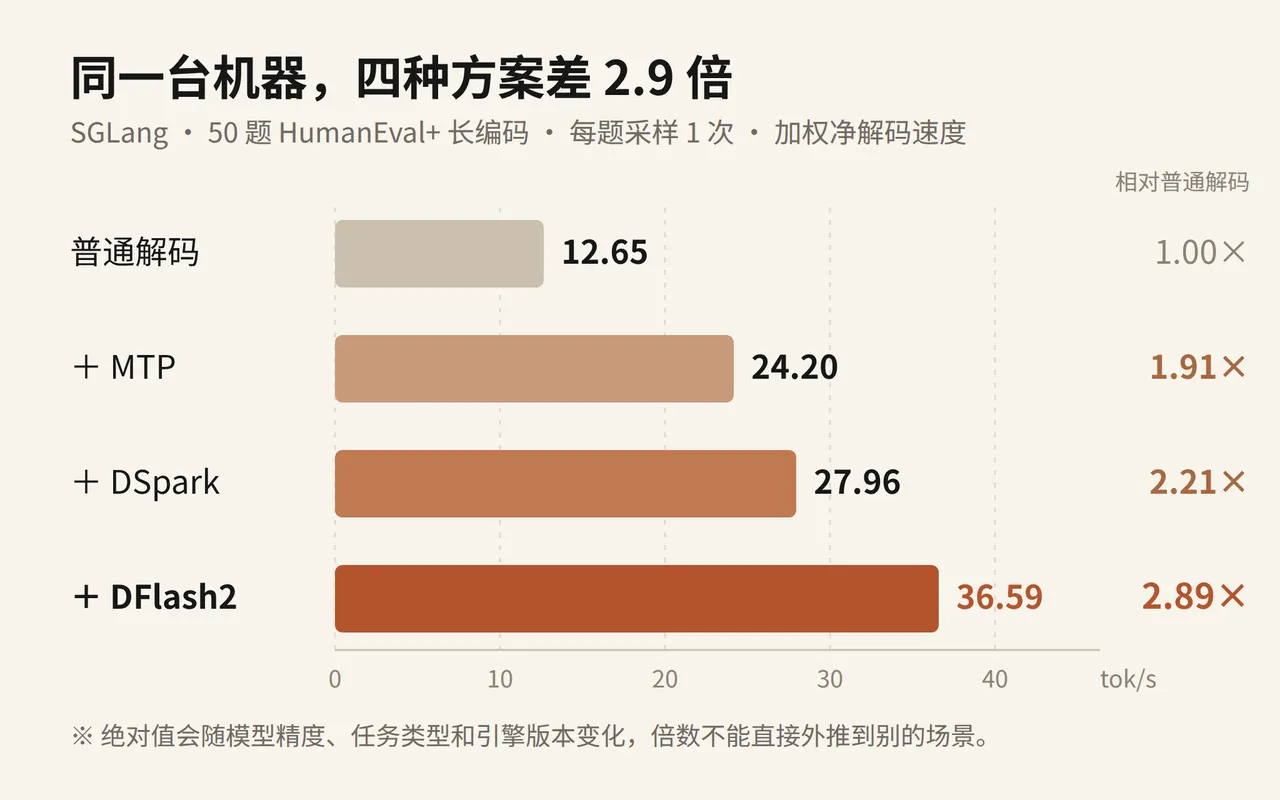
四种解码方案在 SGLang 引擎下的 tok/s 对比:DFlash2 是普通解码的 2.89 倍
但我不建议只看速度就直接把 DFlash2 当成最终方案。它需要单独准备草稿权重,还要匹配对应的推理引擎版本。升级模型或运行时之后,也需要重新验证。
真正上线之前,还是要拿自己的业务任务测一遍。
如果主要用来做 Agent,速度还不是全部
我自己部署 DGX Spark,最终还是希望它能跑本地智能体。
所以除了长文本编码,我还特别关注工具调用。
Agent 调用工具时,输出通常比较短,内容可能是工具名称、参数和状态信息。这个场景和连续生成几千个 Token 的编码任务并不一样。
公开测试中有一组工具调用任务,包含 6 个任务,每个任务运行 3 次,关闭 thinking。
结果里,SGLang + DFlash2 的表现是:
- 原生结构化工具调用:18/18 次通过。
- 中位生成速度:54.99 tok/s。
- 中位延迟:8.44 秒。
- 应用断言得分:143/180。
看起来速度很不错。
但同一组测试中,vLLM + DFlash2 的中位速度是 47.41 tok/s,应用断言得分却达到了 161/180。
速度更快,不代表工具调用的业务结果一定更好。
所谓应用断言,就是检查模型给出的工具名称、参数和状态是否符合任务要求。工具调用如果参数错了,哪怕模型生成得再快,Agent 也可能执行失败。
所以,如果你主要拿 DGX Spark 跑 Agent,我建议不要只测试 tok/s。
至少还要看:
- 工具名称和参数格式是否正确。
- 工具调用成功率如何。
- 模型是否会重复调用工具。
- 多轮调用之后,状态能不能保持正确。
- 长时间运行时是否出现内存压力。
这些指标比单纯追求最高生成速度更接近真实使用体验。
社区里那些 60 tok/s、480 tok/s,到底能不能相信?
折腾过程中,我也看了不少社区分享。
有些人说跑到了 60 tok/s,甚至还有人分享了 16 路并发合计 480.7 tok/s 的结果。
这些数字确实很吸引人。
但看测试结果时,最好先问清楚几个问题:
- 用的是什么模型和量化格式?
- 使用哪个推理引擎?
- 有没有开启 thinking?
- 测的是单请求还是多请求?
- 是长文本生成,还是短工具调用?
- 统计的是单路速度,还是所有请求的总吞吐?
尤其是最后一点。
480.7 tok/s 是 16 路请求的总吞吐,也就是所有并发请求的输出速度之和。它不代表每一个用户都能获得 480.7 tok/s。
就像一条高速公路,16 辆车加起来的通行量很大,并不意味着每辆车都能以同样的速度行驶。
还有一些社区优化方案,只用少量编码题和工具任务做了测试。这样的数据可以作为尝试方向,但还不足以证明它适合生产环境。
所以我现在看社区性能数据,会先把测试条件对齐,再决定是否值得自己复测。
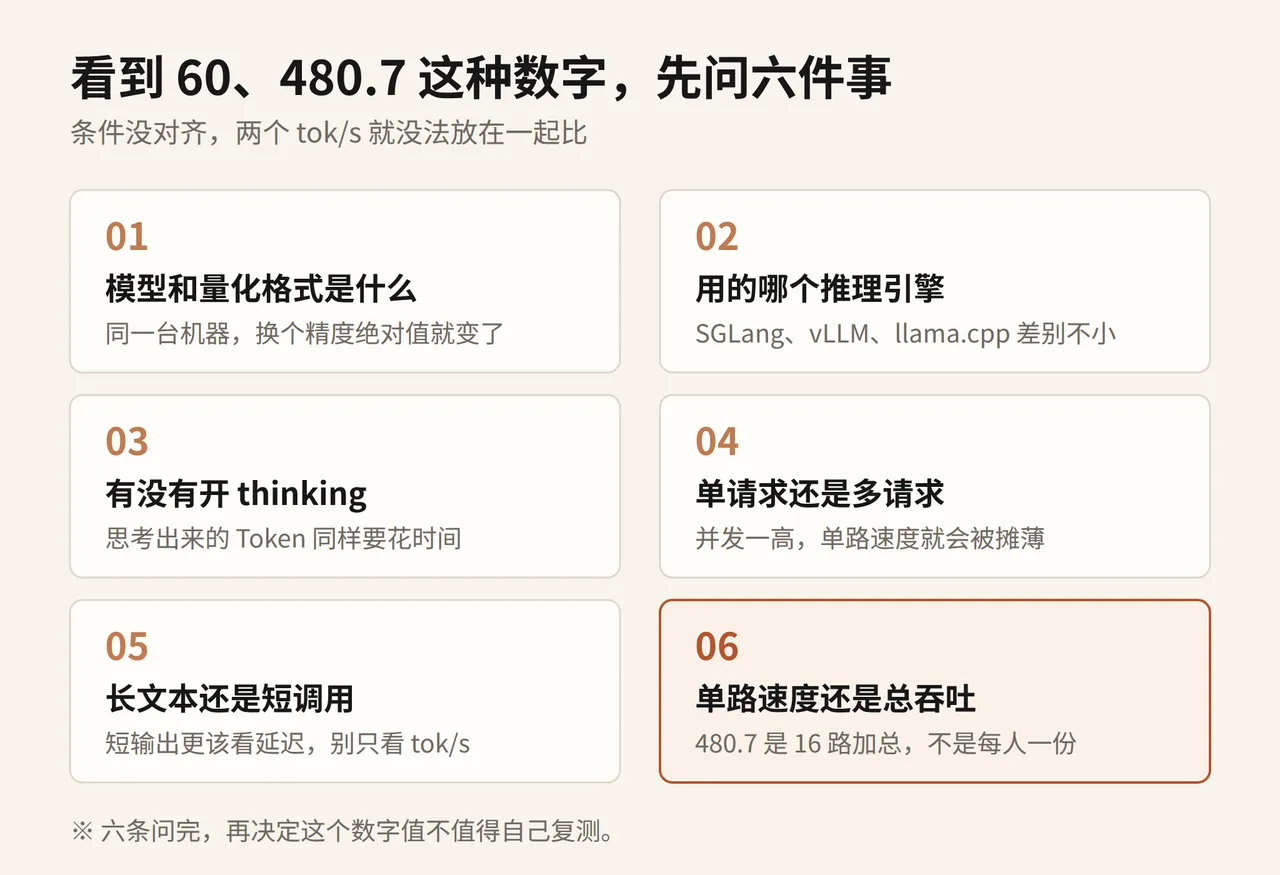
判断社区性能数据前需要先对齐的 6 个测试条件
我现在准备怎么选部署方案?
如果是自己折腾、学习和体验,当然可以多尝试几种配置。
但如果是放在离线内网里,给智能体长期使用,我会更谨慎一些。
目前我的思路是:
第一步,先建立普通解码和 MTP 的基线。 这两种方式比较适合先跑起来,记录同一组任务下的速度、内存和输出质量。
第二步,再测试 DSpark 和 DFlash2。 长编码任务重点观察 DFlash2,DSpark 则要看它在当前引擎和内存配置下是否值得保留。
第三步,换成自己的真实业务任务。 不能只用 HumanEval 这样的公开编码题。最好把日常智能体会执行的任务也放进去,包括代码生成、文件操作、工具调用和多轮任务。
第四步,做压力测试。 尤其要看内存峰值、长时间运行、并发请求和异常恢复。一次启动成功,不等于能稳定运行几天。
第五步,保留回退方案。 新配置如果速度提高了,但维护成本和故障风险也增加了,就要重新评估是否值得替换。
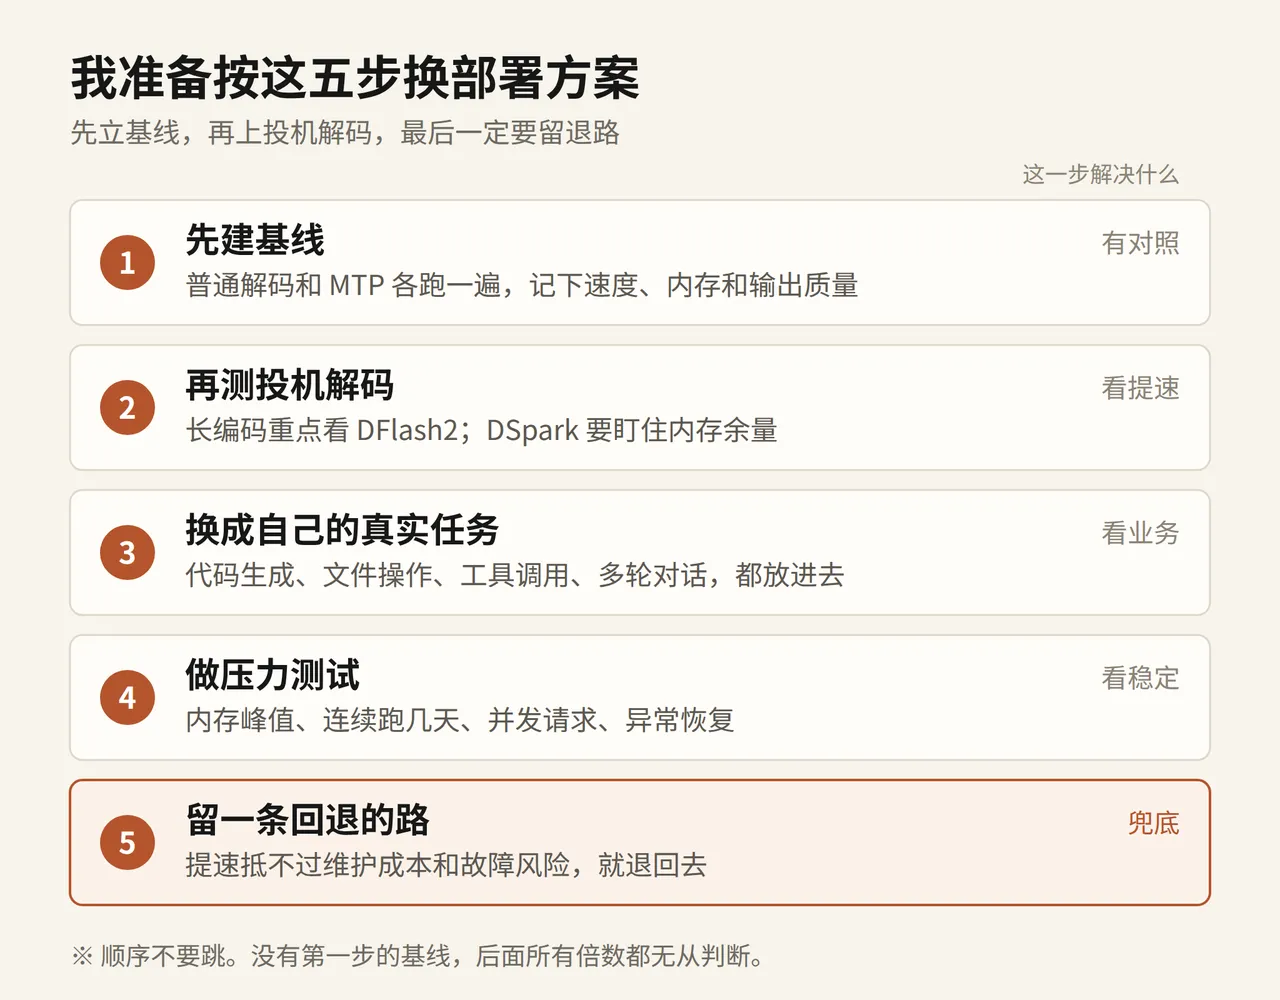
部署方案选型路线:从基线到回退,五步稳扎稳打
我更关心的是,哪套方案能在自己的业务里稳定工作,而不是哪套方案能在某个测试表里拿到最高分。
不只有 DGX Spark,越来越多设备也在采用这条技术路线
还有一点值得关注。
GB10 这条 Grace-Blackwell 技术路线,正在从 DGX Spark 这样的桌面 AI 超级计算机,延伸到更多面向开发者和创作者的设备。
例如:
- ASUS 的 ProArt P16、P14 和 ProArt GR1X。
- Lenovo 的 Yoga Pro 9n。
- Dell 的 XPS 16 Creator Edition。
这些产品采用 NVIDIA RTX Spark N1X 平台,和 DGX Spark 的 GB10 并不是完全相同的芯片型号,但都围绕 Grace CPU、Blackwell GPU 和统一内存架构展开。
这意味着,今天在 DGX Spark 上摸索出来的很多模型部署思路,未来也能给这些设备提供参考。
比如模型格式选择、量化、推理框架、投机解码和 Agent 部署流程。
当然,不能简单地把 DGX Spark 的启动命令原封不动地复制过去。不同设备的操作系统、内存容量、软件环境和驱动版本都可能不同,具体参数仍然要根据机器调整。
但整体的部署思路是相通的。
最后
这段时间折腾下来,我最大的感受是:DGX Spark 的潜力不只是能把一个大模型装进 128GB 内存。
真正值得花时间研究的,是怎么把模型、推理引擎和硬件组合起来,让它在自己的任务里跑得更快、更稳。
普通解码、MTP、DSpark、DFlash2,每种方案都有适合自己的场景。没有一个参数可以保证所有任务都跑得最快。
如果你也在折腾本地模型部署,希望这篇能帮你省几个试错的晚上。
想直接上手的话,关注公众号「第四生产力」,后台回复 dgx,我把这套推理参数发你。