上一篇把话说得挺丧:五层防线,每层都在漏。没读过的补一句背景:五层指的是给 AI 代码把关的五个环节——需求说明、自动检查、AI 加人工审查、测试、小流量发布,上篇逐一拆了它们各自漏在哪。
这篇往回收一收。漏归漏,不代表没用。大多数人是用错了地方——工具管得住的毛病,没人正经用;工具管不住的,大家偏偏指望它兜底。
上篇最后留了个问题:产量已经是机器速度,审查还是人肉速度,中间那道缝怎么办。这篇不灌鸡汤,直接给动作。一层一层来,每层就讲清楚三件事:怎么用、防什么、防不住什么。
第一层:需求说明别写成许愿,写成验收清单
先替给 AI 写需求说明这件事说句好话,这套玩法本身没问题,问题出在写法上。很多人写的东西就是需求复读——“做一个用户登录功能”。这不叫规格,这叫许愿。
一份需求说明值钱的就三样:验收清单、边界、禁止事项。
回头看 Linus 那个竞态就懂了。竞态就是两个操作同时改一份数据,谁先谁后没准儿,上篇讲过。
他的需求说明里性能目标、范围写得明明白白。但”读内存页的时候文件刚好在扩展,撞上了怎么办”这种时序问题,说明里压根没有。不是他不行,是正常人不会往需求里写”两个事恰好赶一块儿了该怎么办”。
所以你写需求说明的时候,有几件事得显式问出来:这段代码会不会有两个人同时改一份数据?输入超出预期范围会怎样?用户传进来的东西,会不会其实是一段命令,不是一段文字?
问出来,写进去,AI 生成的时候就会往这些方向防。不问,它就只满足你写出来的那部分——你没写的,它当不存在。
这层防得住需求跑偏、低级边界。防不住你没问出来的问题。上篇那句结论再摆一次:bug 不长在你写出来的任何地方,只长在你没写的地方。
第二层:静态检查全量强制,但它只管低级错
这层是五层里性价比最高的,就是大家心态不对。
编译器报错、类型检查、代码风格检查(linter)、安全漏洞自动扫描(SAST),正确用法就一句话:全量强制。合并进主干之前统一过一遍,不过检就不许合,零谈判。因为它便宜、快,低级错基本百发百中。
但别误会它的角色。它是个筛子,滤沙子用的。石头——竞态、业务逻辑错、注入——网眼不够大,直接漏。美国国家标准化研究院从 2008 年起办了好几届静态分析工具评测(SATE),结论一直没变过:静态分析的检出能力有天花板,从没突破过。
所以 linter 全绿不等于代码没问题,它只证明”没有低级问题”。两条动作:全量强制;过了这层,脑子里那根弦别松。
第三层:写和审别用同一个”脑子”
这层是现在所有人都在用的:AI 写完,AI 审一遍,人点通过。
先看数。AI 代码审查工具 Greptile 拿自己的题库测自己,报出的检出率 82%;换 Augment 的团队来,同一批代码库、换一套评判规则再测,Greptile 只剩 45%;Augment 测自己,报 59%。
各家测各家的都漂亮,横向一比全对不上。这不是哪家的道德问题,是这类测试本身方差就大。
另一个数来自代码审查工具 CodeRabbit:他们自己分析了平台上 470 个开源项目的合并请求(准备合进主干的代码包),AI 参与写的代码,问题数是人写的 1.7 倍。
为什么?上篇说过——它写的时候瞎的地方,审的时候一样瞎。同一个模型、同一套推理,盲区是共享的。
三个动作,从便宜到贵:
一,换模型审。写用 A,审用 B。不同厂商的模型,盲区位置不完全一样,这是目前最便宜的手段,成本约等于零。
二,给 AI 审查者一份对抗清单,别让它泛泛地”帮忙看看”。泛泛 review 出来的全是”建议提取常量”这种片汤话。要它专找东西。我用的骨架,直接抄:
这段代码里只找三类问题:一,两个操作同时改同一份数据的地方;二,输入超出预期范围时会怎样;三,外部输入有没有可能被当成命令执行。每类给出具体行号和触发条件,没问题就明确说”未发现”,不许给风格建议。
三,你的人工审查时间只盯两样:业务语义,时序。业务语义就是——这行代码做的,是不是业务上要的那个动作。时序就是——两个操作抢一份数据的地方。低级错交给第二层的筛子,别拿人肉时间去重复机器的活。
这层防得住明显逻辑错,换模型之后还能盖掉一部分同源盲区。防不住两个模型共享的盲区——这是真存在的,只是比同源盲区小。
第四层:没有专用工具,就用笨办法摊平运气
谷歌的 Project Zero 安全团队今年 9 月发布了一套叫 MAccConc 的工具,专治内核竞态:强制编排线程的执行顺序,人为制造”恰好同时”,把靠运气才能撞上的 bug 变成必现。
咱们手里没有这套工具,也不用眼红。笨办法有两个。
一个是重复跑。竞态看运气,那就把运气摊平:可疑的并发代码段写个循环跑一万次,有一次结果不对,bug 就现形了。成本是几行测试代码加一杯咖啡。土,但比祈祷线上别撞上靠谱。
另一个是模糊测试。不手写具体输入,让工具自动生成一堆乱七八糟的东西往里灌——超长字符串、空值、特殊字符、并发请求。输入一多,边界条件就容易瞎猫碰上死耗子。主流语言都有现成的模糊测试库,接进测试流程不难。
丑话说前头:这两个手段都不是证明”没有 bug”,是增加”撞上 bug”的概率。对竞态这种玩意儿,普通团队能做到的极限也就到这了。
第五层:小流量发布之后,去核对数据,别只盯报错曲线
竞态这类 bug 的阴险在哪,上篇说了:不爆炸。不报错,不宕机,悄悄把错误数据返回给用户。
所以新功能先放给一小部分用户试水(这叫灰度发布),这个阶段只盯着监控曲线看——错误率、响应时间——看着一切正常,错已经犯完了。
加一道动作:灰度期间做数据对账。新功能放给 5% 的用户之后,抽一批实际操作结果,跟预期比对。读了什么、写了什么、数值对不对。比看曲线多花几个小时,但”不爆炸的错误”只有这一手能让它现形。
兜底靠什么
五层摆完了。你可能会问:一层层都用对了,就安全了吗?
不是。说句实在的,只要代码还在跑,就没有绝对安全。Linus 的补丁都得靠人类审查者事后兜底,你我手上的项目,凭什么指望万无一失。
真正的兜底不是哪一道防线,是两件事。
一是可回滚。任何变更,几分钟内能退回去。功能开关就是干这个的——出问题,一个开关关掉,不用重新发布。要是你的项目加功能还得改库表、发新版才能撤,那风险敞口就大到没边了。
二是影响半径小。回滚之外,还得限制”错一次最多伤多少”。这里要立一条纪律:写入操作——转账、删数据、发消息——和读取操作,必须是两个审批等级。AI 生成的代码,稳定跑过三个月之前,不许碰写入路径。
这条没有任何技术含量,纯纪律。但比前面五层加起来都救命。
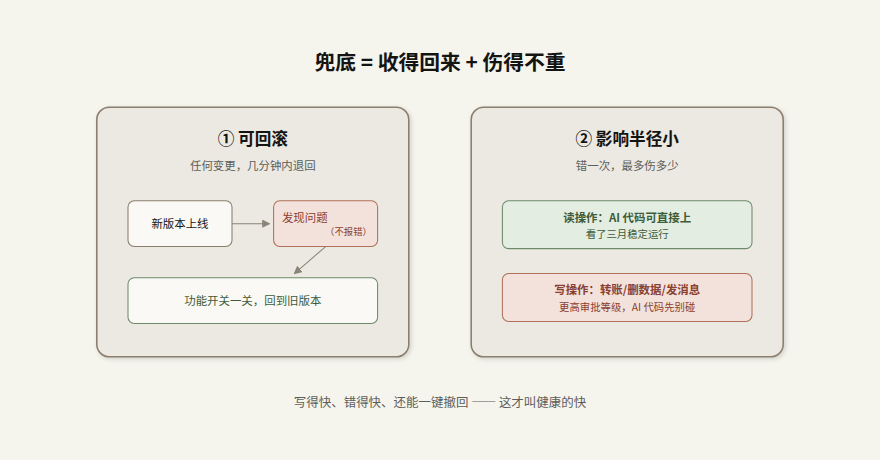
说透了:AI 时代,工程能力的核心不是写得多快——那已经是机器的事了。核心是错了以后,能不能方便地收回来。写得快、错得快、还能一键撤回,这是健康的。写得快、错得隐蔽、撤不回来,这才要命。
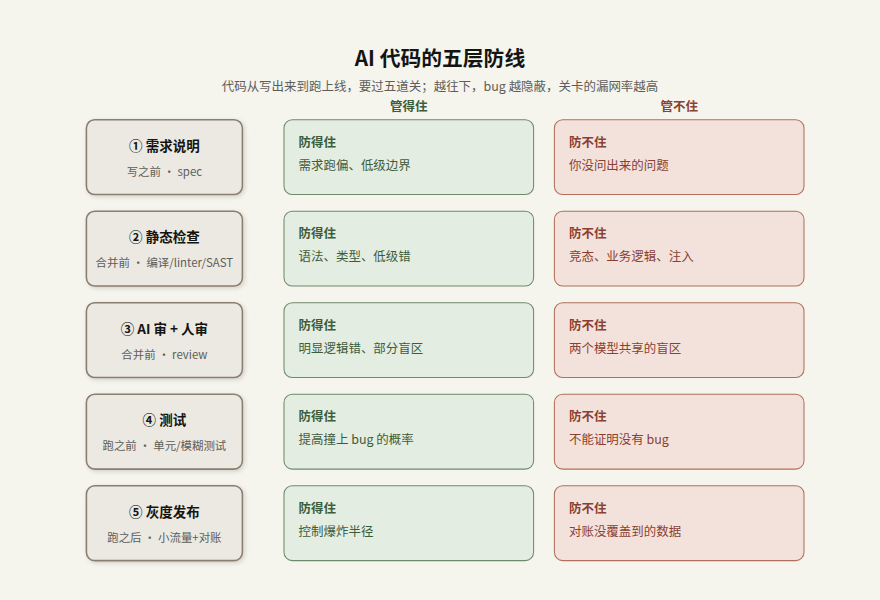
五层摆在一起,就是这张总览图:
实操速查表
| 防线 | 怎么用 | 防得住 | 防不住 |
|---|---|---|---|
| 需求说明 | 写验收清单+边界+禁止事项,并发/时序/安全显式提问 | 需求跑偏、低级边界 | 你没问出来的问题 |
| 静态检查 | 全量强制,过检不等于干净 | 语法、类型、低级错 | 竞态、业务逻辑、注入 |
| AI 审+人审 | 换模型审、喂对抗清单、人只看业务语义和时序 | 明显逻辑错、部分盲区 | 两个模型共享的盲区 |
| 测试 | 循环跑一万次、接模糊测试 | 提高撞上 bug 的概率 | 不能证明没有 bug |
| 灰度 | 放小流量+核对产出数据,不只看错误率 | 控制爆炸半径、抓”不爆炸”的错 | 对账没覆盖到的数据 |
| 兜底 | 功能开关+快速回滚+写入分级审批 | 错得起的架构 | 纪律本身 |
五层各就其位,再留一条回滚的退路——这事才算办成了。