10 月 20 日,一家叫记忆张量的公司开源了两个模型,AI 圈讨论不少。我看完论文,第一反应不是兴奋,而是替很多团队捏了把汗:刚花力气建好 RAG 知识库的企业,看到这种新闻最容易犯的错,是连夜开会讨论要不要推倒重做。
先给结论,免得你白读:不能替代,也不需要推倒重做。但这条新路线确实抢走了一块原来没人管的地盘——下面用论文里的三张原图,把账算清楚。
先看它到底改了什么
传统做法——RAG、各种记忆外挂——逻辑都一样:经验存在模型外面,用的时候检索出来,塞回对话里让模型”看着办”。模型本身没变,每次推理都像翻笔记考试:笔记带着,但这个人自己没进步。
MemT 1.0 走的是另一条路:把”记笔记、翻笔记”这件事焊进模型内部。
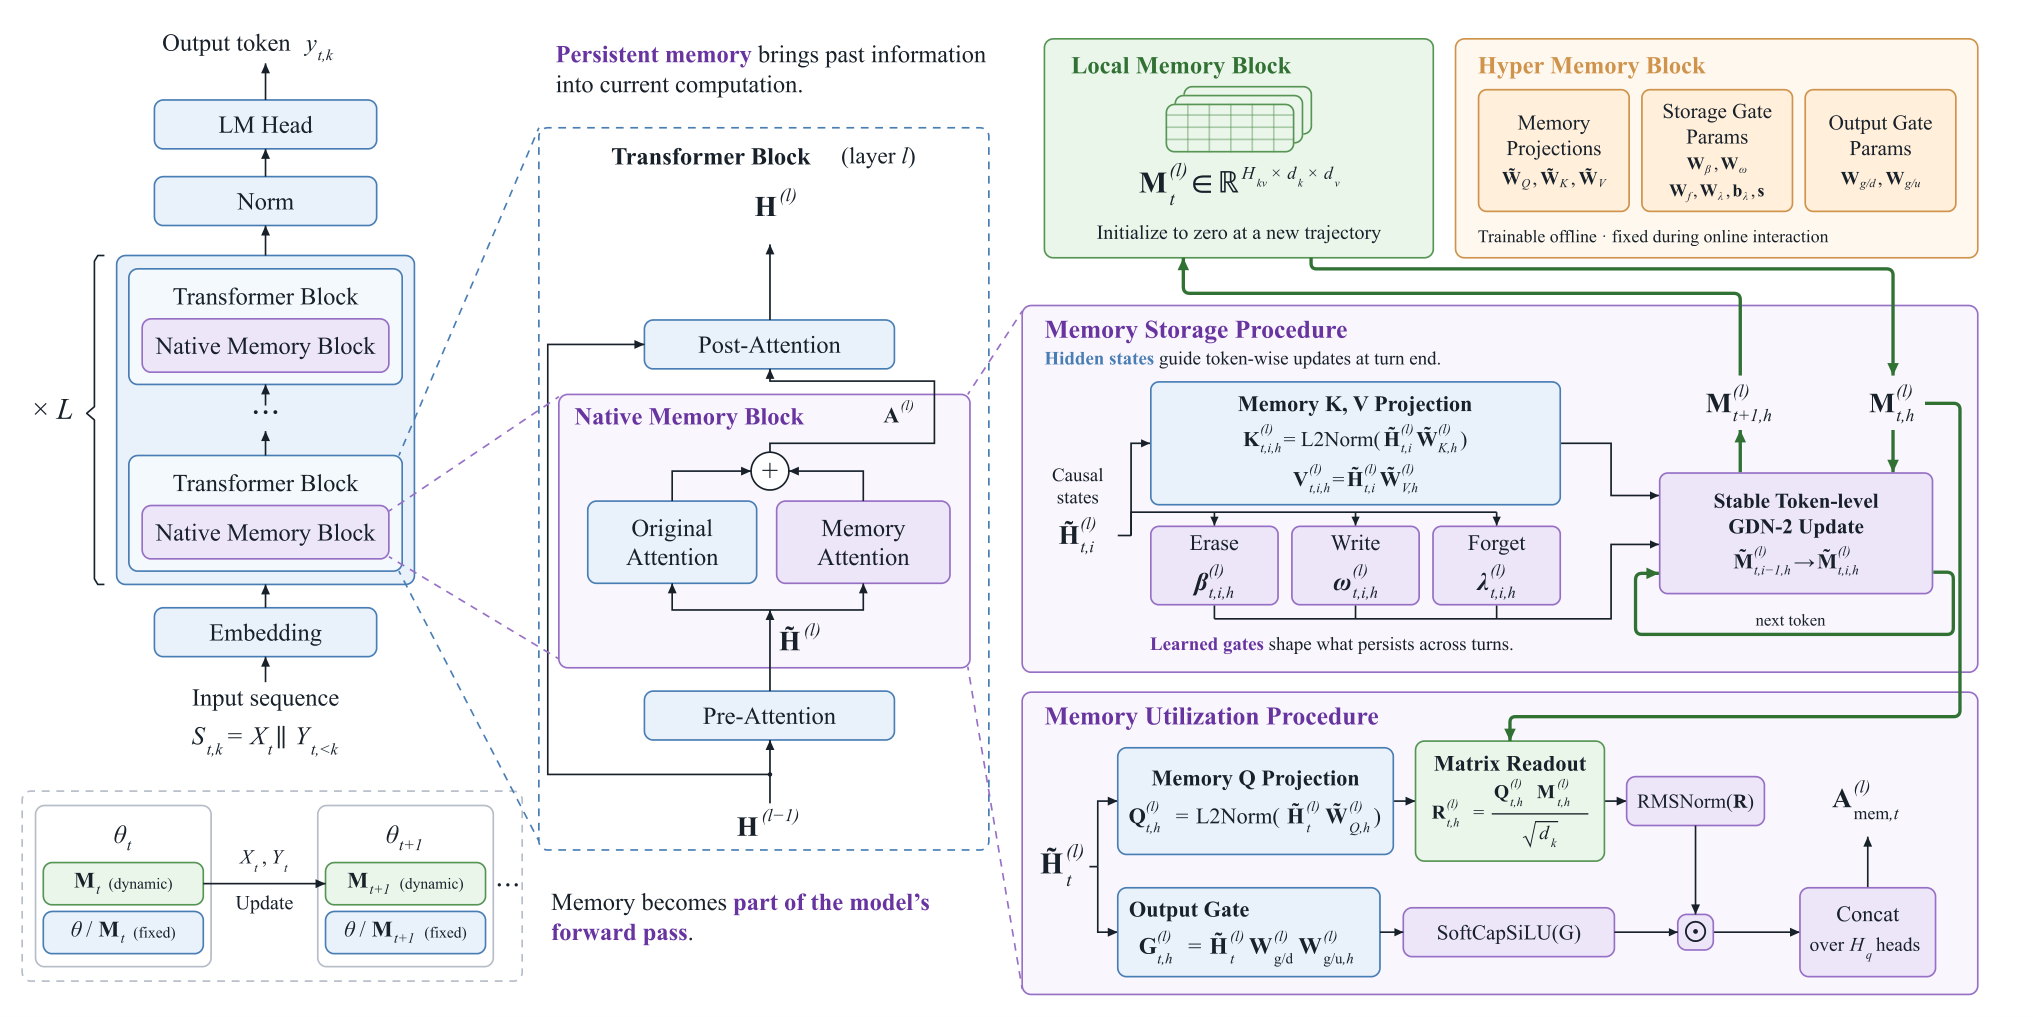
这张图别看公式,就看中间那列:一个 Transformer 模块里,原来的注意力通路旁边并联加了一条”记忆注意力”,两路结果相加再往下走。翻译成人话:模型生成每个字的时候,除了看当前对话,还同时读一份自己维护的”内部状态”——过去交互的压缩版本。
它把东西分成三层,这个分工是关键:
- 主干:模型原有的能力,训练后冻结,线上运行时一动不动;
- 超记忆:一套可训练的”读写开关”,决定什么值得记、怎么取——这是训练出来的能力;
- 局部记忆:真正存内容的那块矩阵,随着你跟它聊天不断更新,会话结束还在,跟人走。
所以”记忆原生”四个字的意思:记忆不再是往上下文里塞文本,而是模型自己会写、会改、会读的一份内部状态。训练的时候,答题对错会反过来教它”该记什么”——这是外挂检索库永远得不到的反馈回路。
它真正强的账:越用越久,但不越用越贵
企业用 Agent 都撞到过这堵墙:会话越长,上下文越大,钱和延迟线性上涨;历史长了只能截断,截断就丢经验。
论文的实测图给了另一组数字:
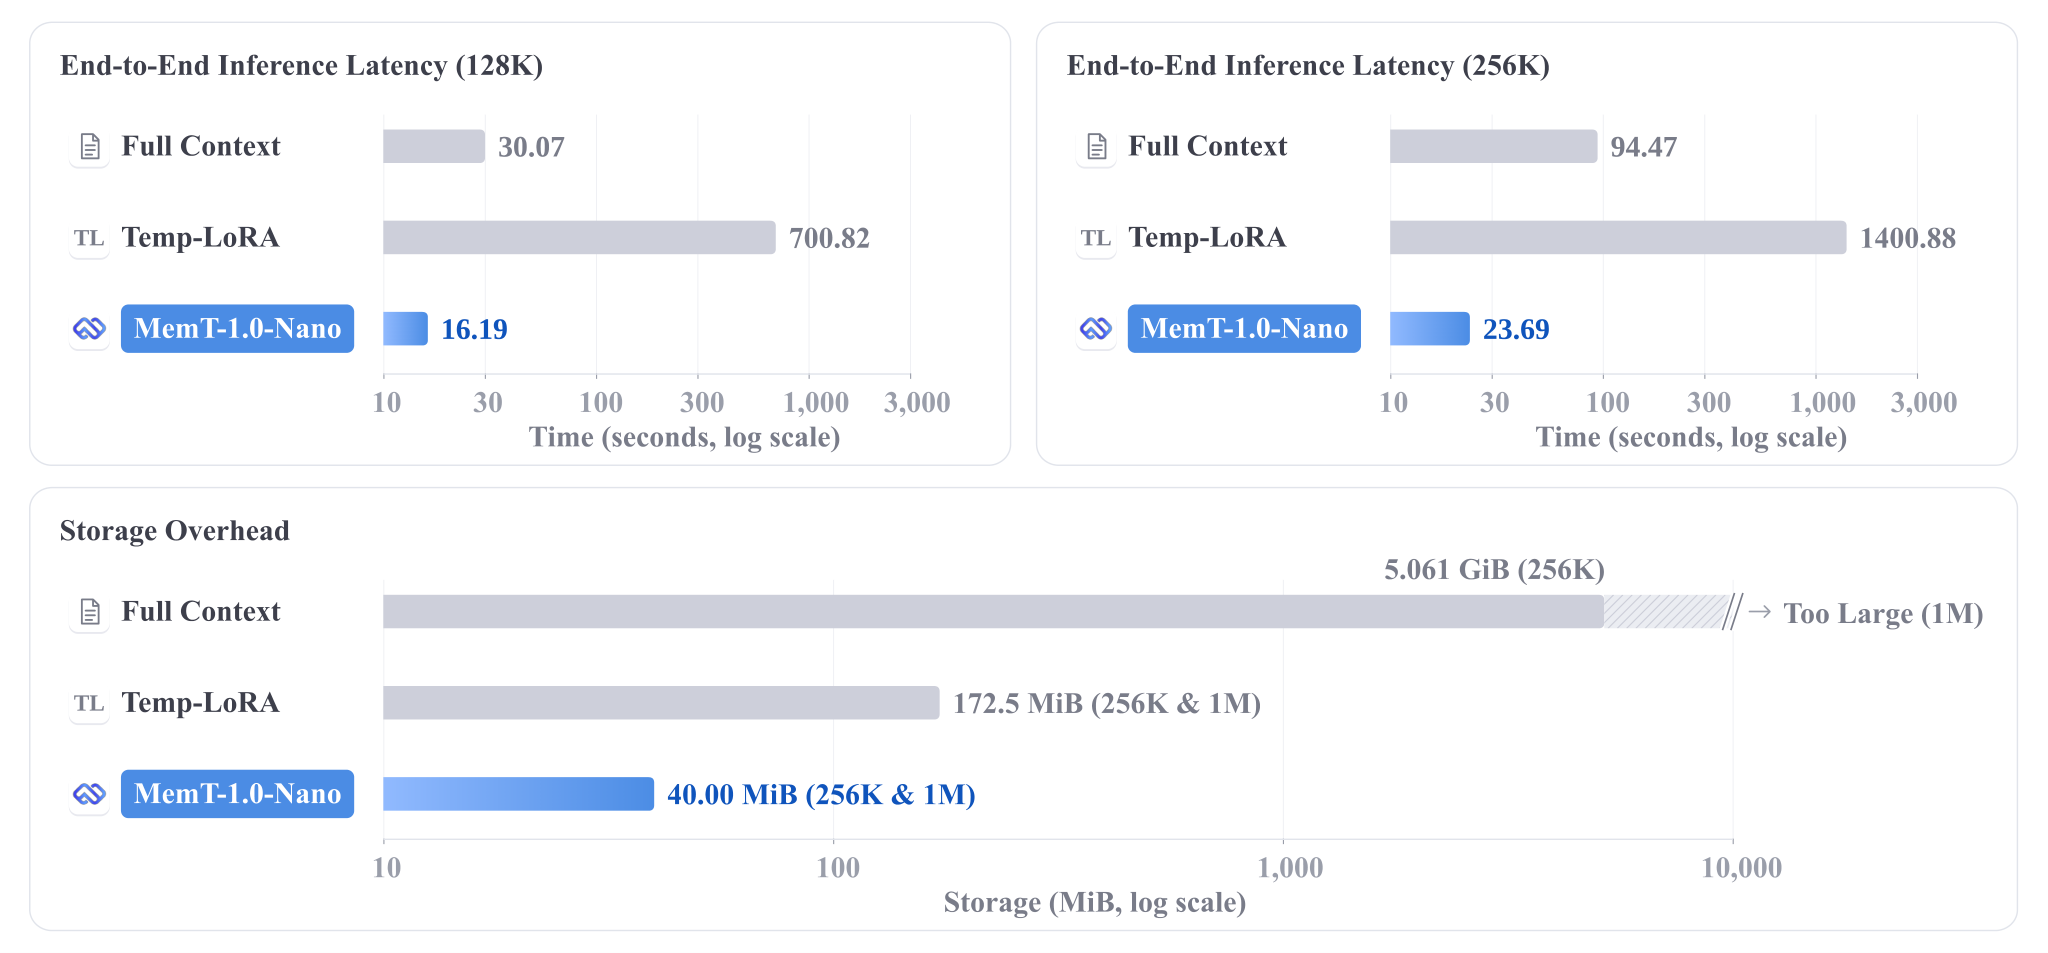
读图说三件事(双 GPU、单并发条件):
- 历史到 12.8 万 token,完整塞上下文的方案端到端要 30 秒,MemT 只要 16 秒——快 1.86 倍;历史翻倍到 25.6 万,差距拉大到 3.99 倍;
- 最狠的是底下那条:保存”一个人的全部历史”,全量 KV 缓存要 5.061 GiB,MemT 的内部状态只有 40 MiB,不到 1/66,而且历史再长它也不涨;
- 首字响应时间不随历史变长——聊到 25.6 万 token,全量方案等 445 毫秒,它还是 110 毫秒左右。
这意味着什么?“长期陪伴型 Agent”第一次在成本上算得平账。过去这个产品做不起,不是体验问题,是每个老用户都在把你的推理成本往上抬。
但是,RAG 能撤吗——论文自己画的对比图
好,重头戏。论文 Figure 1 把”文本记忆”(左边灰区:MemOS、DenseRAG、Graphiti,全是 RAG 流派)和”参数化记忆”(右边蓝区:MemT 领衔)放进六个基准同台对比:
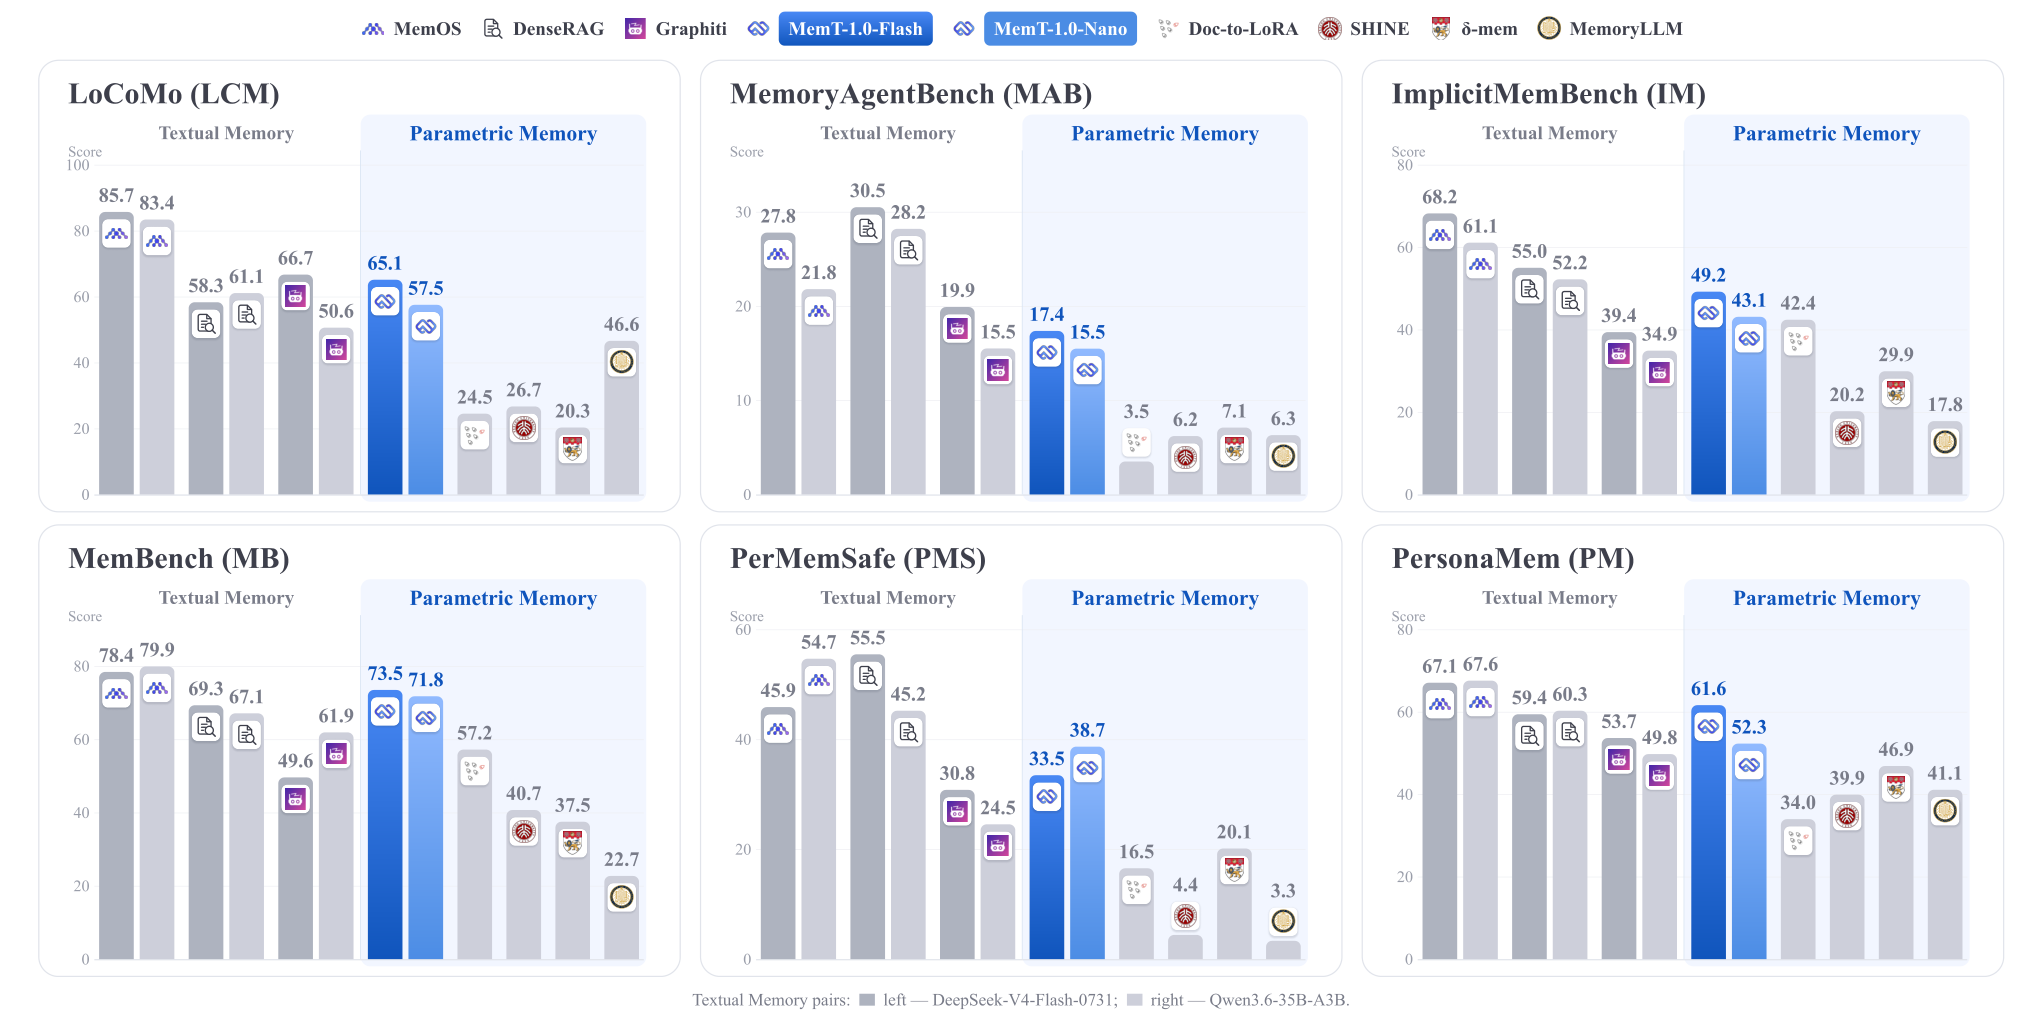
读图结论很直白:六个基准里,灰区的 RAG 阵营几乎全线压着蓝区打。 最扎眼的是左一 LoCoMo(长对话问答):MemOS 拿 85.7 分,MemT 最大的 288B 型号只有 65.1 分。论文原话也没回避:最强的文本记忆系统在细节召回上”仍然显著更强”。
为什么会这样?机制决定的。MemT 的历史被压缩进一块固定大小的矩阵——40 MiB 装 25.6 万 token,就不可能原文都还在。它是”记住了大意和套路”,不是”背下了每一页”。你要它复述三个月前那份合同的第 7 条第 2 款,它真做不到;RAG 翻笔记一翻一个准。
所以第一个问题的答案:查询、溯源、精确复述这类活儿,RAG 的地盘纹丝不动。 谁要是劝你把知识库推了换原生记忆,让他先拿这图说话。
那它抢的是谁的活儿?第三方记忆外挂该不该慌
这是你的第二个问题,答案更有意思。
论文第 7 节做了个对照实验:同一批”经验”(比如”修 bug 前先写复现测试”这类做事方法),用两种方式喂给模型——A 组以文本形式塞进上下文(就是记忆外挂的老办法),B 组写进 MemT 的本地记忆矩阵。然后在 500 道真实 GitHub 修 bug 任务上各跑三遍。
三组数字:不喂经验,成功率 66.07%;文本经验,69.13%;原生记忆,69.73%。
打平。原生记忆第一次做到了跟”把经验写成文本喂进去”几乎同等的效果——而且不是靠占上下文、不是靠检索命中,是模型自己”想起来的”。执行轨迹也变了样:有经验的模型动手改代码前会先写复现测试,改完还回头查边界条件;没经验的上来就改,错了再补。
所以它抢的地盘,说得精确一点:不是”查资料”,是”学做事”。 你给 Agent 挂的经验库、SOP 库、踩坑记录,如果用法是”每次任务前检索出来塞进提示词”,那这正是 MemT 们要内化的东西。第三方记忆厂商自己也懂——这次发布 MemT 的记忆张量,主业卖的就是 MemOS 这套文本记忆系统,它是左手打右手一起发了。
但”该不该慌”要分场景。慌的资格取决于你的经验长什么样:
- 经验是方法(先复现再修、报价前先核成本):能被压缩、能被学习,原生记忆路线吃得下;
- 经验是凭证(合同条款、客户工单、版本记录):要原文、要出处、要能审计——文本记忆仍是唯一解,论文数据就摆在那,65.1 对 85.7,别被”断崖领先”的通稿标题带跑。
企业现在该做什么:一张分工表
我的判断,未来一两年企业 AI 的记忆架构大概率长这样——两条腿分工,不是二选一:
| 需求 | 该用谁 | 原因 |
|---|---|---|
| 精确原文、来源可溯、合规审计 | RAG / 文本记忆 | 保真,细节召回碾压(Figure 1 实测) |
| 长会话、多轮陪伴、跨天任务的”手感” | 盯紧记忆原生 | 成本账只有它算得平(1/66 存储) |
| 组织级 SOP、流程约束的强制执行 | 文本 + 人批 | 可编辑可删除可解释,出问题能说清 |
| 个人偏好、隐性经验的持续复用 | 记忆原生的试验田 | 这正是它”越用越顺手”的设计目标 |
再补一句组织层面的冷水——这属于作者判断,论文没测:原生记忆带来一个新的合规麻烦,它记住的东西不可逐条解释,也难以精确删除。RAG 库里存了什么,列清单就能审计;模型内部状态里沉淀了什么”经验”,目前没好办法一条条查。GDPR 式的”被遗忘权”落到模型头上怎么执行,是这条路线进生产的必答题。你的安全团队现在就该把这个问题记在风险台账上,不用等到选型。
最后说一个比技术更要紧的变化
记忆原生把一件事的产权变了:经验沉淀在模型状态里,而这部分能力第一次归部署方,不再只归模型厂商。 你用出来的判断、踩出来的路数,理论上跟着你这份模型走,而不是变成厂商下一次的训练素材。对企业来说,这可能比那 1.86 倍提速值钱。
不用推倒 RAG,但”经验归谁、怎么积累”这道题,从这篇论文开源那天起,正式摆上企业 AI 的桌面了。
留个问题给你掂量:如果你的 Agent 有一天真的”越用越懂你司业务”,但没人能说清它到底记住了什么——你敢不敢让它上生产?评论区聊聊你的答案,下一篇就顺着这个问题写。