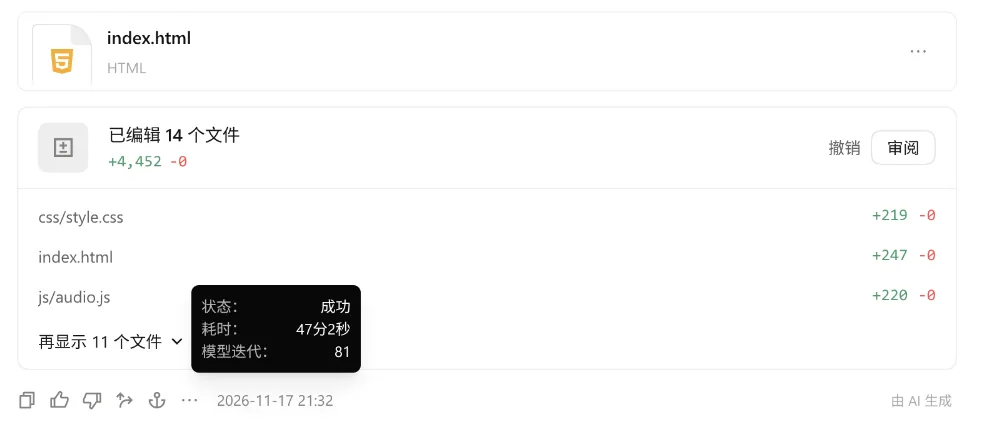
47分钟做出网页版CF,
Qwen4-Max离Fable 5.2的“惊艳”还差多远?
最后,浏览器里真的出现了一款第一人称射击游戏:有沙漠灰风格地图,有M4A1、AK-47和AWM,有敌友BOT、雷达、手雷、医疗包,也有完整的计分和结算。
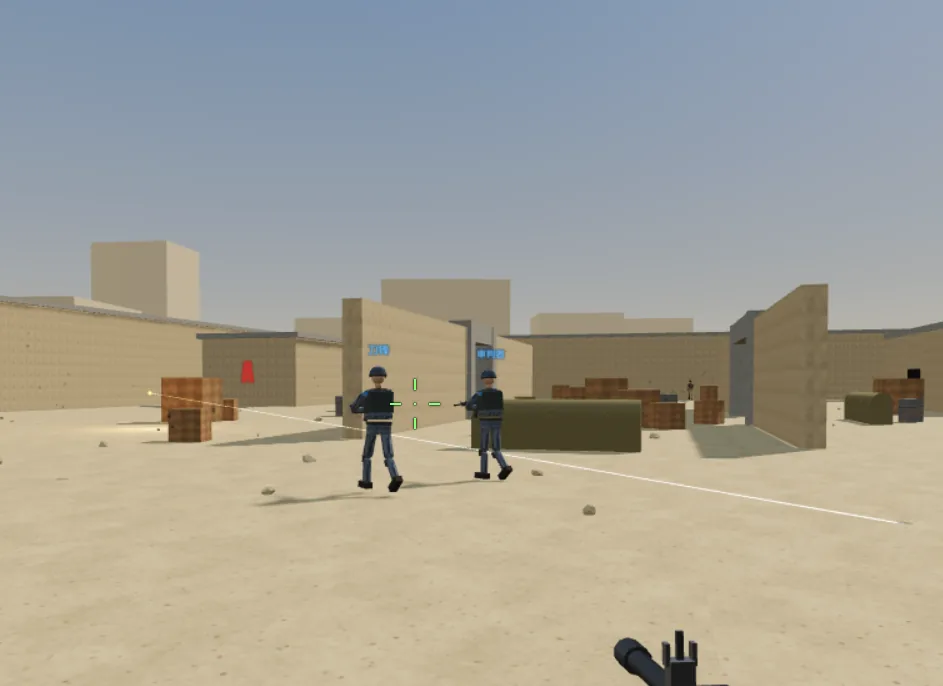
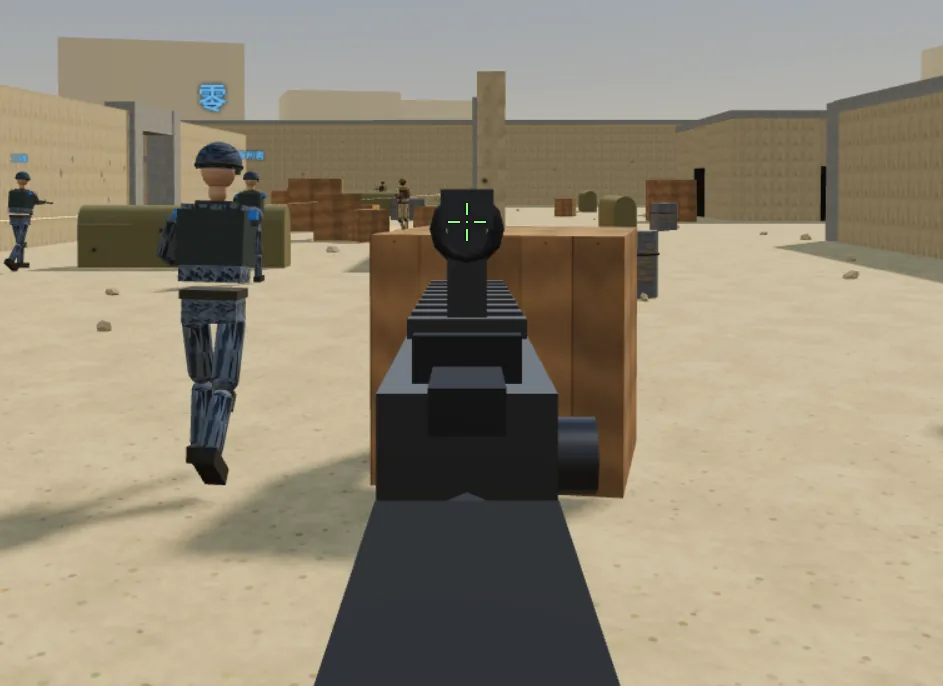
但当我真正端起枪,问题同样直观:场景像未经装修的积木沙盘,机瞄视野被黑色瞄具挡住,爆炸像几张发光贴片,被击杀后甚至还能继续跑动。
这就是本次Qwen4-Max实测最有意思的地方:它不是“做不出来”,而是很快做出了一个能玩的原型,却没有在首版把“能玩”继续打磨成“好玩、好看、像一件作品”。
先纠正一个参照物:
《几猫》不是另一款独立作品
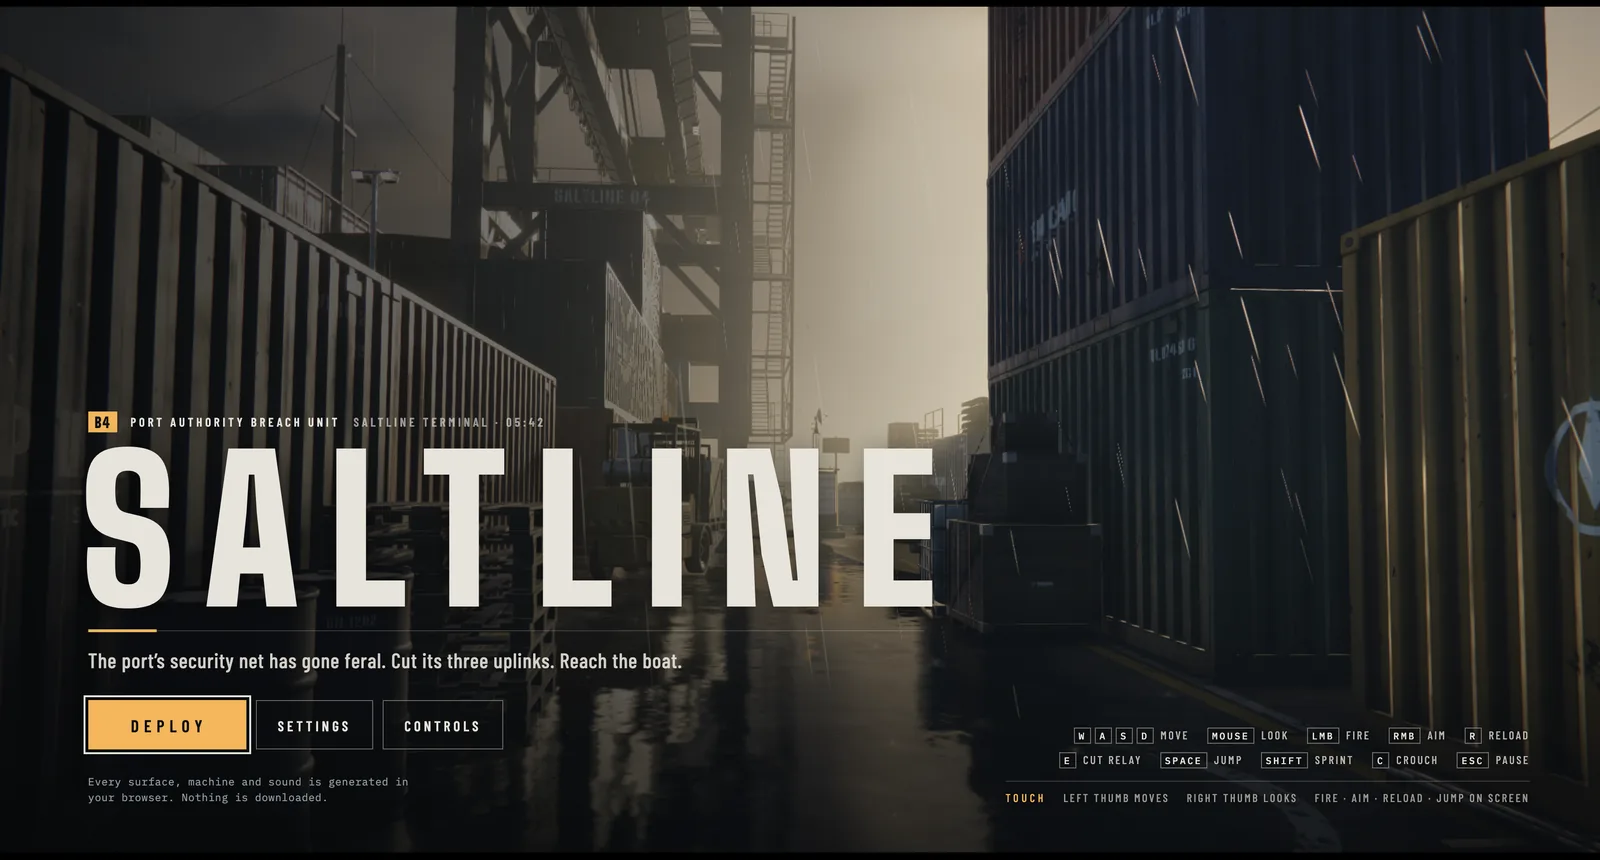
最近不少人把《几猫》当成“国内作者用Fable 5.2做出的游戏”,但公开报道已经指出,它实际上是Anthropic工程师Felix Rieseberg的《Saltline》的汉化改名版。
游戏研究社和虎嗅的核查都提到,《几猫》的源代码仍留有“SALTLINE”痕迹,原作者署名却被移除。虎嗅进一步报道称,原版约6200行代码中,《几猫》只改了约100行,主要集中在界面翻译和新增项目介绍。
所以,下文真正拿来比较的是《Saltline》原作,而不是把《几猫》当成另一个独立模型样本。
先说优点:
它的工程完成度,比画面更值得肯定
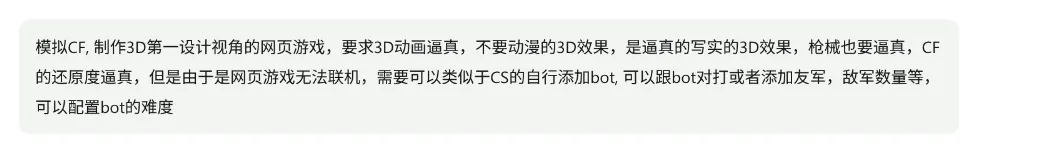
这次需求文字不长,核心只有四点:模拟CF、画面写实、BOT补位、敌友数量与难度可调。
但这个题目比“做一个小关卡”更系统工程化。模型不仅要处理画面,还要同时处理地图碰撞、角色状态、武器数值、BOT感知和寻路、比赛流程,以及一整套HUD。
Qwen4-Max最后交付的不是一个只会旋转视角的3D场景,而是一局真的可以打完的团队竞技。
第一,BOT不是摆设。
它有视线和听觉感知、反应延迟、最后已知位置、A*寻路、巡逻、交火走位、点射、换弹、死亡与重生。四档难度也不只是改伤害倍率,还会改变视野、反应时间、散布、转身速度和爆头倾向。
第二,FPS需要的基础系统基本齐了。
五种武器、弹匣与备弹、后坐力、移动散布、部位伤害、护甲、换弹、机瞄、狙击开镜、近战、手雷抛物线、医疗包、雷达、击杀播报、计分板和赛后结算,都有对应的实际逻辑,而不只是菜单上的文字。
第三,它考虑了离线运行和性能档位。
项目使用Three.js,贴图、角色、枪械和音效主要通过程序生成,还提供画质、音量、鼠标灵敏度等设置。首版就能运行到比赛结束,说明Qwen4-Max已经具备相当完整的原型交付能力。
如果需求是“快速验证一套网页FPS玩法”,它已经合格。
问题出在,我的需求里还有四个字:逼真、还原。
差距一:不是“低多边形”,
而是没有完成写实目标
低多边形本身可以是一种美术风格,但这次提示词明确要求写实,所以眼前的方块感不能被解释成风格选择。
地图里,大片墙面和地面缺少结构变化,箱体、掩体和远景建筑都以简单几何体为主;角色虽然由多个部件组成,仍然像拼装木偶;沙色材质覆盖了大部分视野,缺少能形成视觉记忆的地标和层次。
《Saltline》走的则是另一条路。它只做一个雨夜集装箱港口,却围绕这个场景组合了集装箱、起重机、湿地面、积水反射、锈迹、剥漆、雨幕和低角度光。玩家还没开枪,场景就已经讲清楚了自己是什么地方。
雨夜和湿地当然比白天沙地更容易制造氛围,但选择什么场景、用什么元素形成氛围,本身就是模型自主设计和审美判断的一部分。
Qwen4-Max首版更像是在实现“一个FPS应该有哪些对象”,Fable 5.2则更像是在组织“这个FPS应该给人什么感受”。
差距二:射击游戏的关键,
不只是子弹能打出去
首版里,机瞄是最影响体验的问题之一。举枪后,大块黑色瞄具占据画面中心,既没有正常红点镜的通透感,也谈不上舒适瞄准。
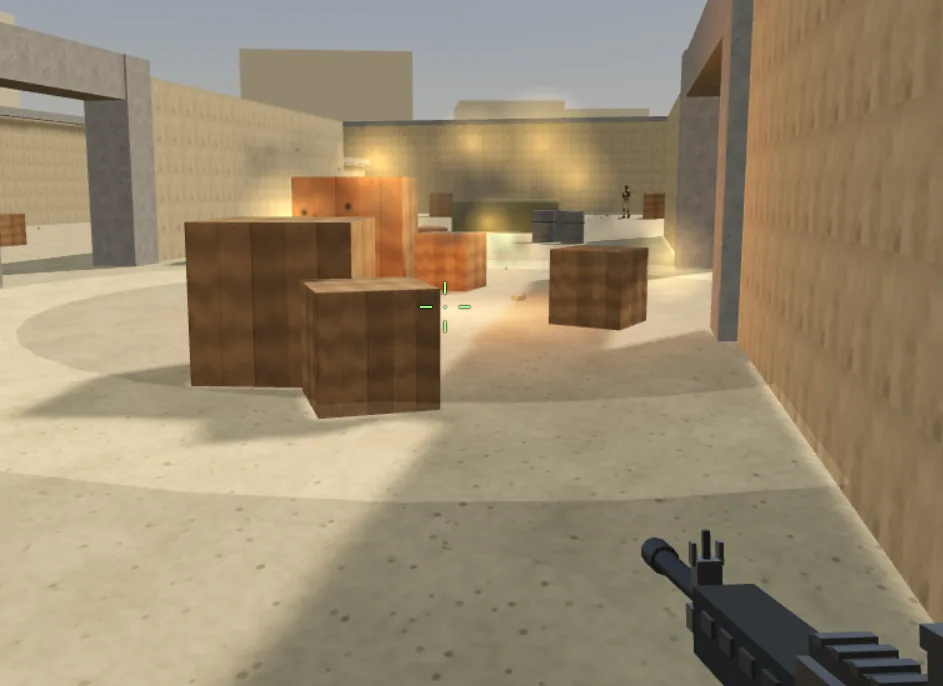
爆炸也缺少完整的视觉层次。火光、烟尘、冲击和碎屑没有形成足够有力量感的组合,看起来更像几张半透明贴图叠加。
《Saltline》的强项恰恰在这些“玩起来才知道”的地方:枪械模型、开镜视野、枪口闪光、不同材质反馈、弹壳与脚步、环境声和战斗音乐共同维持射击反馈。
差距三:首版验收停留在“能运行”,
没有充分覆盖“状态是否合理”
首版录屏里,被BOT击杀后,玩家仍能继续跑动、转动视角,第一人称枪支也留在画面中。
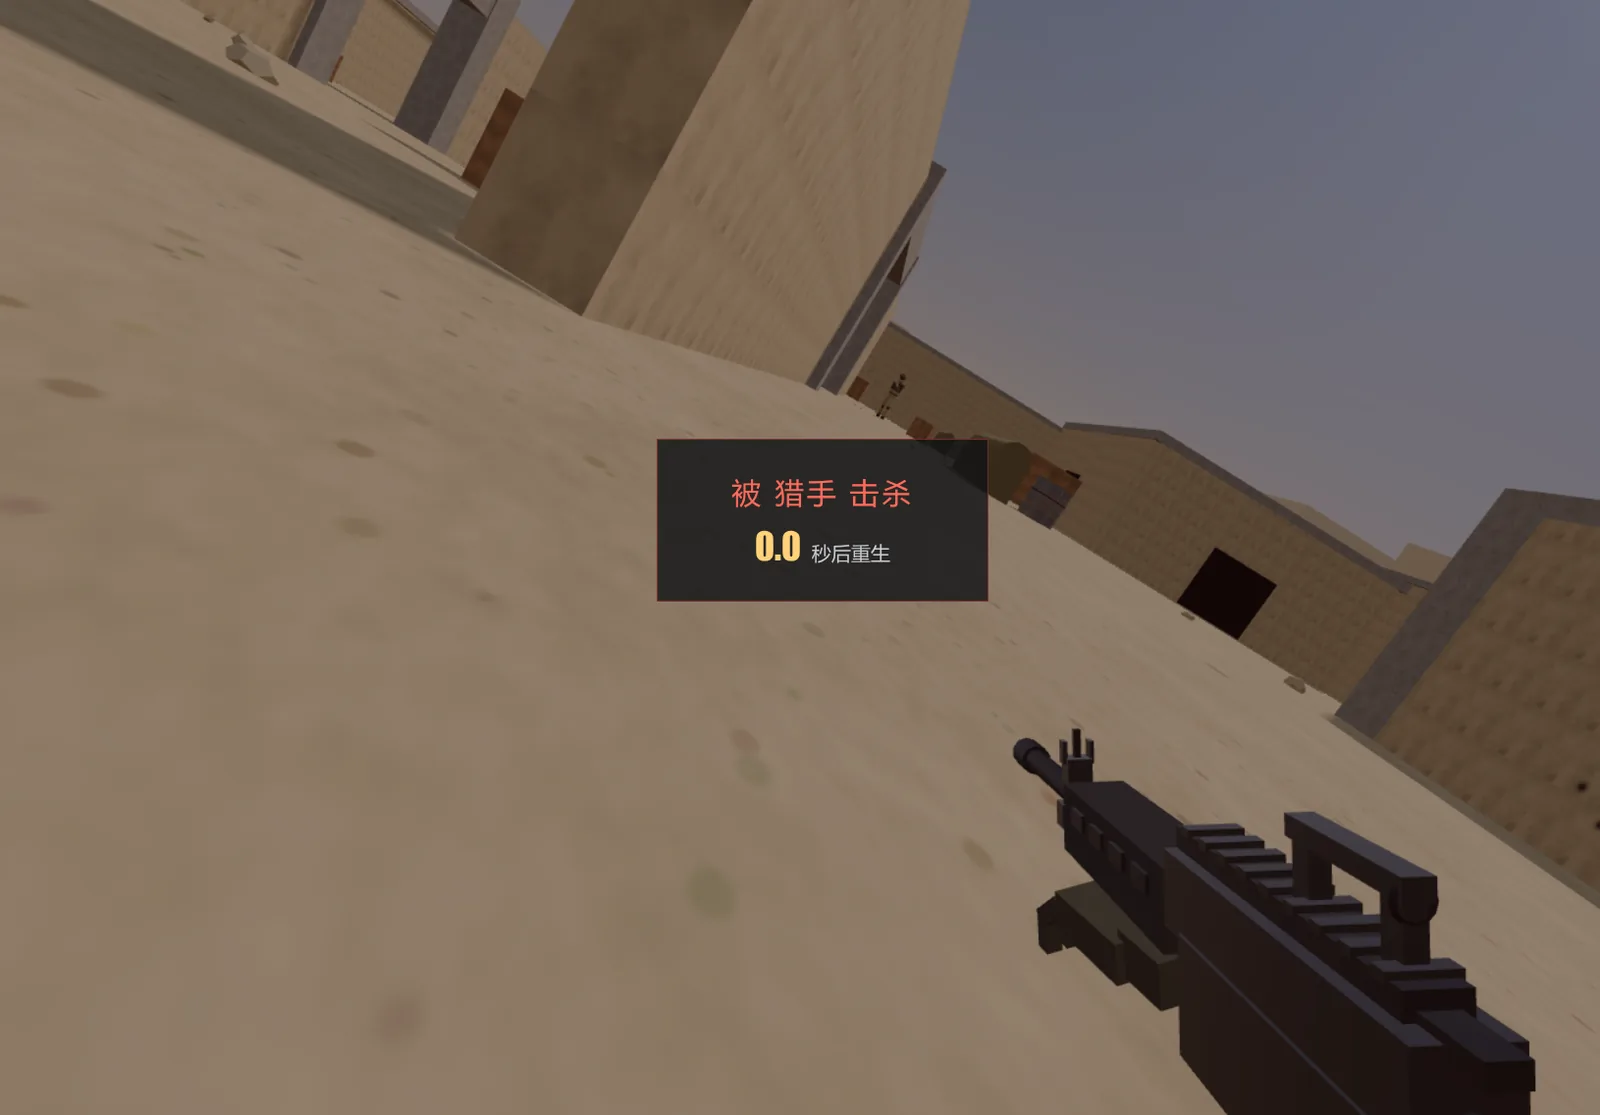
这类问题比“画面粗糙”更能说明验收深度。它不是增加美术资源就能解决的,而是需要模型真正检查死亡、暂停、重生、切换武器等状态之间是否互相打架。
值得肯定的是,后续Qoder又针对死亡行为、瞄具透明、爆炸效果和人物模型进行了修补。当前代码已经加入死亡后的输入限制、死亡时隐藏第一人称武器,以及透明镜片等逻辑。
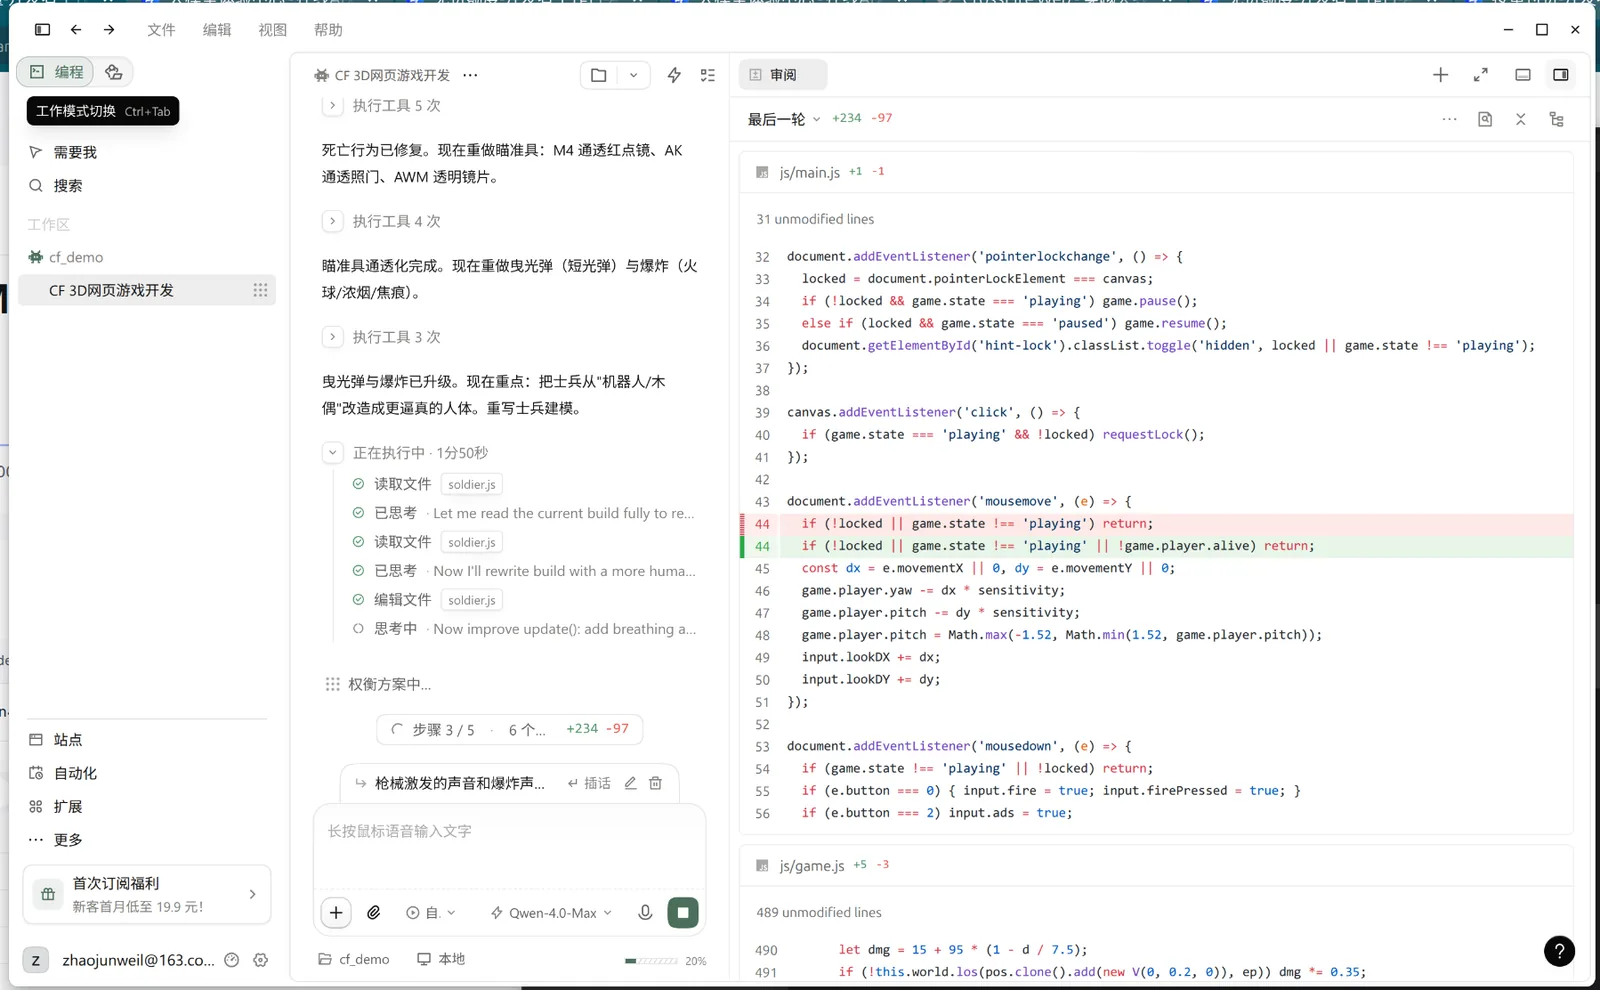
这也说明,首版问题不等于模型的能力上限。但它同时暴露出一个倾向:模型先交付了功能清单,却没有主动把最关键的体验路径验收到底。
至于修补后的画面究竟提升了多少,仍应以新一轮实机录屏为准,不能只看“已修复”三个字。
但这不是一场同预算、
同流程的严格横评
如果只拿47分钟的Qwen首版,去对比《Saltline》现在最精致的公开页面,然后直接宣布谁“碾压”谁,也不公平。
Felix公开的数据是:《Saltline》初版由一条提示词启动,无中途人工反馈,模型自主运行约8小时,消耗约4.45亿输入Token和270万输出Token,按API价格折算约550美元。当前公开版本还经过约2小时的后续改进。
它的提示词也明确把范围限制为“一个小关卡”,重点追求照片级画面。相比之下,我这次要求Qwen同时完成CF风格、敌友BOT和难度配置,系统范围更大,视觉目标却没有被拆成可验收的细节。
所以,这次结果可以证明“成品完成度存在明显差距”,却不能精确推导出“同样8小时、同样Token预算,Qwen一定做不到什么程度”。
《Saltline》本身也只是几分钟流程的技术demo,不是内容量、玩法深度和制作规模都达到商业3A标准的完整游戏。它足够惊艳,但不必被神化。
模型之外,
Qoder和平台数据也值得一说
Qoder把编程和通用工作模式放在同一个产品里,切换方便;从生成项目到继续修补,流程是顺的。不过这是产品体验,不能直接算进底层模型能力。
千问AI平台的用量页则显示:当时累计140次请求,其中139次为qwen4-max,成功率100%;qwen4-max平均首包延迟约3.17秒,平均总延迟约28.6秒。
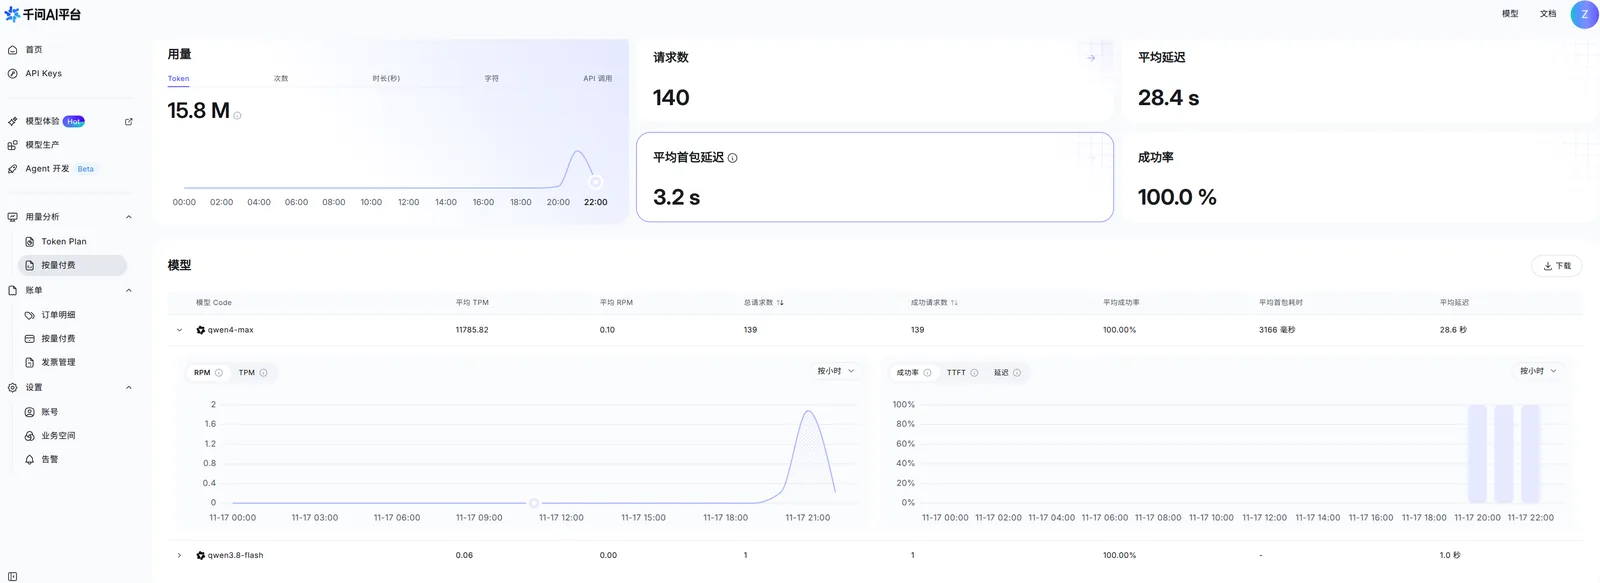
100%请求成功,不等于100%任务合格。
请求没有报错,和游戏是否达到写实目标,是两件事。
3.17秒首包、28.6秒总延迟,不能脱离任务长度比较。
在连续修补时,等待感确实明显;但没有同任务、同推理档位的对手数据,不能仅凭这张图断言谁更快。
页面没展示缓存命中率,不等于没有缓存。
阿里云官方文档显示,Qwen4可以通过API响应中的缓存读取、缓存创建Token字段计算命中率。对长Agent任务来说,建议平台把这些指标直接聚合成项目视图。
另外,用量页的15.8M Token是当时页面汇总值,还包含一次其他模型请求。没有项目级明细,不能把15.8M全部算作这款CF demo的消耗,更不能直接和《Saltline》的4.45亿输入Token做倍数比较。
Qwen4-Max会“搭游戏”,
Fable 5.2更会“完成作品”
这次测试后,我不会说Qwen4-Max不会做游戏。
恰恰相反,它已经能在较短时间内,独立搭出一套包含BOT、武器、地图、碰撞、HUD和比赛流程的可玩原型。拿来做玩法验证、内部演示和代码起点,价值很直接。
但如果目标是“一句话生成一个让人愿意转发的产品级demo”,首版还缺三样东西:
- 视觉系统的组织能力。不是把材质、光源和粒子分别写出来,而是让它们服务同一个场景和氛围。
- 面向体验的设计判断。知道哪些功能该克制,哪些细节会直接影响瞄准、命中、死亡和重生的感受。
- 主动验收与打磨。不停留在页面能打开、比赛能结束,而是实际检查关键操作、状态切换和画面目标是否成立。
因此,我对Qwen4-Max这次表现的评价是:工程原型合格,视觉与体验完成度不足;效率令人印象深刻,首版审美和自验收仍有明显提升空间。
如果要做下一轮严格横评
建议两个模型使用完全相同的题目、工具权限、时间与Token预算,并分别保留首版和最终版。不要只录最精彩的几秒,至少统一验收:
- 首次打开、开始游戏、暂停与恢复;
- 腰射、机瞄、换弹、切枪、投掷与爆炸;
- 玩家死亡、等待重生、重新获得控制;
- BOT发现敌人、丢失目标、重新搜索和寻路;
- 一整局结束后的计分与重开;
- 同一台设备上的帧率、加载时间和内存占用;
- 总Token、缓存读取、实际费用、人工反馈次数与最终完成度。
最好把“视觉小关卡”和“BOT团队竞技”拆成两道题。前者考美术、渲染和氛围,后者考系统、AI和状态管理,避免用一个模型的长项遮住另一个模型的长项。